Bản tương tác
Bài có kèm một trang tương tác: sơ đồ, tình huống và session minh hoạ. Link mở được tạo mới mỗi lần bấm.
Tóm tắt nhanh: Model càng mạnh thì một prompt mơ hồ càng đắt, vì nó tự tin làm sai thay vì dừng lại hỏi. Cách mình làm với Fable 5 là dồn model đắt vào khâu tìm unknowns (những điều mình chưa biết) và ra quyết định, rồi để model rẻ hơn thực thi theo kế hoạch, với vài chốt kiểm cố định quanh bước code. Bài này ghép hai bài viết trên X của Thariq và Alex Finn vào workflow AgentKit mình đang dùng, kèm bảng chọn chốt kiểm theo mức rủi ro và bảng chọn model theo công đoạn.
Fable 5 đắt, nên câu hỏi không phải dùng nó ở đâu cũng được, mà dùng nó ở khâu nào thì đáng tiền nhất. Hai bài trên X giúp mình trả lời câu đó: A Field Guide to Fable: Finding Your Unknowns của Thariq (@trq212) và The Most Valuable Thing You Can Do With Fable 5 của Alex Finn. Mình ghép ý của hai bài vào hệ skill của AgentKit (trước đây là ClaudeKit), thêm ba skill tự viết rồi ra một pipeline sáu giai đoạn bám sát ý của Thariq: tìm unknowns trước khi code.
Công khai: mình là maintainer của AgentKit và có quan hệ affiliate: link AgentKit trong bài là link affiliate, mua qua link này bạn được giảm 30%.
Lệnh trong bài dùng tên skill dạng ak-<tên> của AgentKit, áp dụng từ bản 3.0.0-beta.35 (21/10/2026). Trước đó lệnh viết là /ak:plan, và lúc mình mới dựng workflow này thì còn là /ck:plan. Cách gọi tuỳ runtime: Claude Code gõ /ak-plan, Codex gõ $ak-plan. Bài ghi theo kiểu Claude Code, bạn đổi tiền tố cho đúng runtime của mình. Mình bắt đầu từ khung bản đồ và lãnh thổ, rồi nhìn qua ba skill tự viết, pipeline và chuyện chọn model cho từng công đoạn.
Bản đồ và lãnh thổ: khoảng cách đó chính là unknowns
Prompt và ngữ cảnh bạn đưa cho Claude là bản đồ. Codebase và các ràng buộc thực tế là lãnh thổ. Khoảng cách giữa hai thứ đó gọi là unknowns.
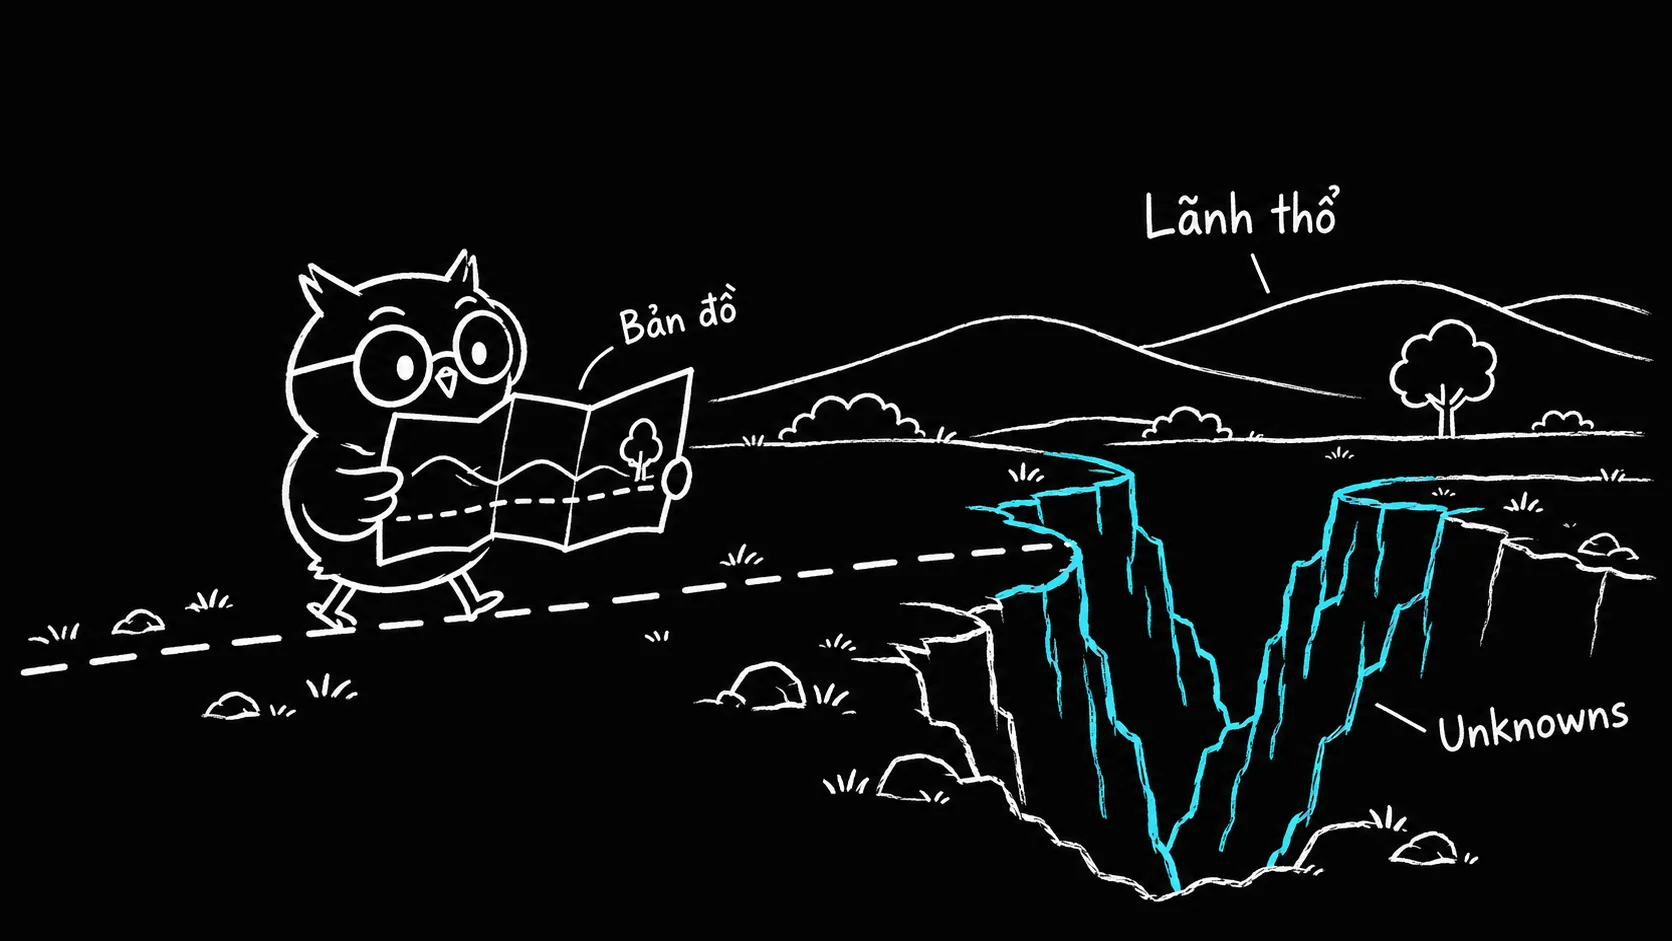
Với Fable 5, chất lượng kết quả bị giới hạn bởi việc bạn làm rõ unknowns tới đâu, không phải bởi năng lực của model. Model càng mạnh, cái giá của một bản đồ tồi càng lớn, vì nó sẽ tự tin đi sai hướng thay vì dừng lại hỏi.
Thariq dùng ma trận Rumsfeld để chia unknowns khi bạn viết một prompt thành bốn loại:
| Loại | Nghĩa là gì | Ví dụ |
|---|---|---|
| Known knowns | Điều bạn đã viết rõ trong prompt. Claude chỉ cần đọc và làm theo, không phải đoán. | Tên endpoint cần thêm |
| Known unknowns | Điều bạn biết là mình chưa quyết định. | Đánh đổi giữa hai cách làm, tên biến, cách chuyển dữ liệu |
| Unknown knowns | Tiêu chuẩn kiểu "nhìn là biết" nhưng bạn không nói thành lời được. Nó chỉ lộ ra khi kết quả sai. | Giọng văn, cách đặt tên mà cả nhóm vẫn ngầm theo |
| Unknown unknowns | Câu hỏi bạn không biết là mình cần hỏi. Đây là khoảng trống nguy hiểm nhất và là mục tiêu chính cần khử. | Một chỗ khác trong repo cũng phải sửa theo mà bạn không biết |
Nguyên tắc rút ra: tìm unknowns càng sớm thì sửa càng rẻ. Tìm ra sau khi đã merge thì chi phí sửa đắt gấp nhiều lần, vì lúc đó lãnh thổ đã bị bản đồ sai định hình.
Ba skill tự viết để lấp ba khoảng trống
Ba skill dưới đây không thuộc bộ lõi của AgentKit. Mình dựng chúng để lấp đúng ba chỗ mà cách làm này cần: tìm unknown unknowns trước khi code, ghi lại chỗ lệch kế hoạch ngay lúc nó xảy ra, kiểm xem người có thật sự hiểu thay đổi sau khi code hay không.
Cả ba để công khai: tải bộ ba skill (.zip). Mỗi skill là một thư mục có SKILL.md, viết trung lập với runtime nên dùng được ở Claude Code, Codex và các runtime đọc SKILL.md khác.
File zip có một thư mục ngoài fable5-unknowns-skills/. Giải nén xong, chép ba thư mục con bên trong (giữ nguyên references/ và assets/ của quiz-gate) vào thư mục skill của runtime bạn dùng, sao cho đường dẫn cuối là ~/.claude/skills/blindspot/SKILL.md với Claude Code hay ~/.codex/skills/blindspot/SKILL.md với Codex. Ba skill không mang tiền tố ak- vì chúng không nằm trong kit AgentKit. Trong Claude Code bạn gọi /blindspot, trong Codex gọi $blindspot.
| Skill | Dùng khi | Kết quả |
|---|---|---|
/blindspot | Trước khi code ở vùng code lạ hoặc mảng kiến thức mới | Báo cáo unknown unknowns có bằng chứng và một prompt sắc hơn cho bước sau |
/impl-notes | Trong lúc code, khi gặp trường hợp biên | File implementation-notes.md ghi quyết định, chỗ lệch và bất ngờ ngay lúc xảy ra |
/quiz-gate | Trước khi merge hoặc khi đọc PR của người khác | Trang HTML giải thích thay đổi kèm câu đố hành vi, trả lời đúng hết mới được merge |
/blindspot: quét điểm mù trước khi vào lãnh thổ
Dùng khi bạn bước vào vùng code lạ hoặc một mảng kiến thức mới, trước khi code.
- Đọc codebase và đào
git logđể tìm unknown unknowns của người dùng, không làm hộ việc. - Mọi phát hiện phải dẫn bằng chứng: file cụ thể, mã commit hoặc tài liệu. Suy đoán chung chung không được chấp nhận.
- Mẹo đáng giá nhất: tìm commit từng làm việc tương tự (
git log --grep), rồi chạygit show --stat <hash>. Danh sách file commit đó đã đụng tới chính là checklist những chỗ cần chạm, thường là tín hiệu tốt nhất bạn có.
Kết quả chính là một prompt tốt hơn, dán thẳng vào /ak-brainstorm hoặc /ak-plan ở bước sau.
/impl-notes: ghi chỗ lệch kế hoạch ngay lúc nó xảy ra
Dùng trong lúc code, khi gặp trường hợp biên hoặc cần để lại ghi chú bàn giao.
- File
implementation-notes.mdghi ba mụcDecisions,Deviations,Surprisesngay tại thời điểm chúng xảy ra, không phải hồi tưởng cuối session như/ak-journal. - Quy tắc ghi chép nằm ngay trong phần đầu của file, không dựa vào trí nhớ hội thoại, vì compaction (nén ngữ cảnh) sẽ làm rơi quy tắc khi hội thoại dài ra. Agent nào đọc lại file cũng tự nhận lại quy tắc đó.
- Gặp trường hợp biên lệch kế hoạch thì chọn phương án bảo thủ (thay đổi nhỏ nhất, dễ đảo ngược nhất), ghi bốn dòng rồi đi tiếp. Không dừng lại chờ người dùng cho một quyết định có thể đảo ngược. Luật này không cho phép hành động không đảo ngược được, đụng tới bảo mật, tác động ra hệ thống bên ngoài hay vượt phạm vi; những việc đó vẫn phải hỏi.
File này nuôi trực tiếp quiz-gate (chỗ lệch kế hoạch là chất liệu ra đề tốt nhất) và /ak-journal.
/quiz-gate: người kiểm tra người
Dùng trước khi merge, hoặc khi đọc PR của người khác.
- Sinh một trang HTML giải thích thay đổi (tóm tắt, bối cảnh, trực giác, phạm vi ảnh hưởng) kèm câu đố về hành vi, không phải câu đố vặt kiểu đổi tên biến.
- Chốt chỉ đạt khi bạn trả lời đúng hết các câu hỏi về hành vi của thay đổi. Skill không tự chặn hay tự merge gì trong repo; đạt chốt là điều kiện bạn tự đặt cho workflow của mình trước khi merge. Sai câu nào thì skill giải thích khái niệm bị hiểu sai bằng đúng đoạn code liên quan, rồi ra câu mới nhắm vào chỗ đó, lặp tới khi đạt.
- Một chỉnh sửa quan trọng: trong lúc chốt đang chạy, báo cáo có phần giải thích và câu hỏi nhưng không có đáp án. Đáp án chỉ được ghi vào HTML sau khi chốt kiểm kết thúc (đạt hoặc huỷ). Nếu ghi trước, người dùng đọc thấy đáp án thì chốt kiểm mất ý nghĩa. Riêng chế độ
--report-onlybỏ phần hỏi đáp trực tiếp và ghi sẵn đáp án trong các mục thu gọn, dùng khi bạn chỉ cần bản giải thích.
Kết quả của quiz-gate là điều kiện để chạy /ak-git hoặc /ak-ship.
Pipeline sáu giai đoạn
Mỗi giai đoạn là một lần trả trước chi phí tìm unknowns, lúc nó còn rẻ.
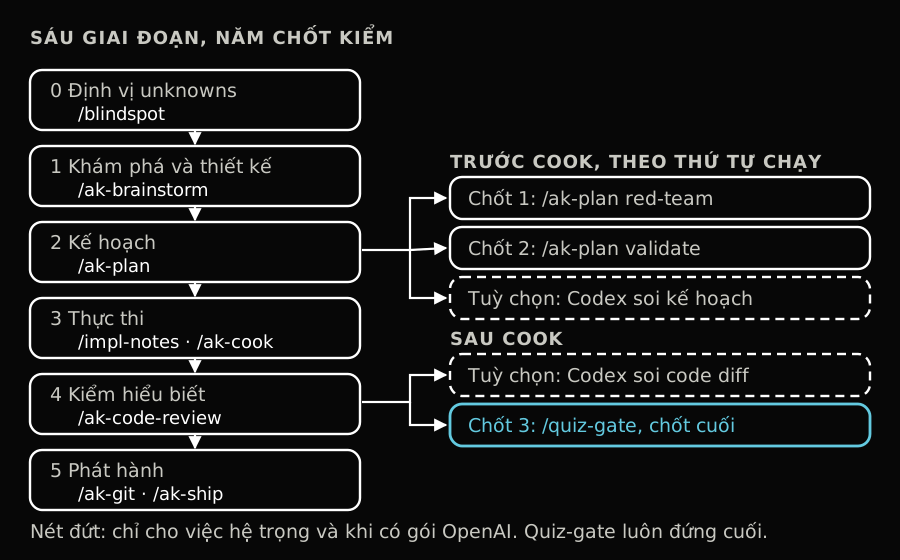
| Giai đoạn | Lệnh | Việc chính | Thêm khi rủi ro cao |
|---|---|---|---|
| 0. Định vị unknowns | /blindspot | Quét codebase và lịch sử git, ra báo cáo unknown unknowns, các "ổ gà" và một prompt sắc hơn cho giai đoạn 1 | |
| 1. Khám phá và thiết kế | /ak-brainstorm --html | Nhận prompt từ blindspot, đọc codebase, phỏng vấn bạn, đưa ra hai ba cách làm và một tài liệu thiết kế | /ak-predict (nhiều persona tranh luận) hoặc /ak-scenario (dò trường hợp biên theo nhiều chiều) |
| 2. Kế hoạch | /ak-plan (hoặc --tdd) | Xuất plans/<ts>-<slug>/plan.md và file cho từng giai đoạn | red-team (agent đóng vai đối thủ xé kế hoạch), rồi validate (đối chiếu kế hoạch với codebase thật). Trường hợp hệ trọng và có gói OpenAI: thêm /codex:adversarial-review trên kế hoạch, chạy sau cùng |
| 3. Thực thi | /impl-notes init, /ak-cook, /impl-notes review | Tạo implementation-notes.md trong thư mục kế hoạch trước khi cook. /ak-cook <plan> triển khai; lệch kế hoạch thì chọn phương án bảo thủ, ghi bằng /impl-notes log rồi đi tiếp. Cuối session, /impl-notes review chắt lọc bài học cho session sau | |
| 4. Kiểm hiểu biết | /ak-code-review, rồi /quiz-gate | Code review là máy kiểm code, quiz-gate là người kiểm người. Hai trục khác nhau | Có gói OpenAI: chen /codex:adversarial-review trên code diff vào giữa hai lệnh, đoạn chỉ hướng lấy từ mục Deviations của impl-notes |
| 5. Phát hành | /ak-git hoặc /ak-ship, kèm /ak-journal | Commit và push, hoặc chạy quy trình PR, chỉ sau khi chốt kiểm ở giai đoạn 4 đạt. Journal đọc impl-notes để nhìn lại |
Ba chốt kiểm cố định và hai chốt kiểm chéo model quanh ak-cook
Đây không phải các bước kiểm trùng nhau. Mỗi chốt kiểm (gate) nhắm một loại unknowns riêng và đứng ở một trong hai đầu của bước thực thi. Theo thứ tự chạy:
- Chốt 1, trước cook:
/ak-plan red-team, khử unknown unknowns của kế hoạch. - Chốt 2, trước cook:
/ak-plan validate, khử known unknowns của các quyết định. - Chốt tuỳ chọn, trước cook:
/codex:adversarial-reviewtrên kế hoạch, chỉ cho trường hợp hệ trọng, cần gói OpenAI. - Thực thi:
/ak-cook. - Chốt tuỳ chọn, sau cook:
/codex:adversarial-reviewtrên code diff, khử unknown unknowns của chính model, cần gói OpenAI. - Chốt 3, sau cook và là chốt cuối:
/quiz-gate, khử unknowns của bạn về thứ sắp phát hành.
/quiz-gate luôn đứng cuối, vì người là điều kiện dừng.
Chốt 1: /ak-plan red-team, agent kiểm tra agent
Vài subagent đóng vai người duyệt khó tính xé bản kế hoạch để tìm kiểu thất bại chưa ai nghĩ tới. Phát hiện nào không kèm bằng chứng file:line cụ thể bị loại tự động, để tránh những lời chê mơ hồ.
Chốt 2: /ak-plan validate, chạy sau red-team và trước cook
Đây là bước kiểm "bản đồ và lãnh thổ" theo nghĩa đen: grep codebase xem những gì kế hoạch nhắc tới (file, symbol, endpoint) có tồn tại thật không. Sau đó skill hỏi bạn một loạt câu để chốt các giả định còn bỏ ngỏ. Thứ tự red-team trước, validate sau là có chủ đích: để agent xé và sửa kế hoạch xong rồi mới chốt với người, tránh chốt trên bản nháp sắp bị sửa lại.
Chốt tuỳ chọn: /codex:adversarial-review trên kế hoạch
Chốt này chạy trước cook, sau validate, chỉ khi bạn có gói OpenAI. Chỉ dành cho trường hợp hệ trọng: chuyển dữ liệu, bảo mật, hoặc giao diện công khai (public contract: API (Application Programming Interface), định dạng dữ liệu mà hệ thống khác đang phụ thuộc). Nó chạy sau cùng ở giai đoạn kế hoạch, khi kế hoạch đã qua red-team và validate, để tấn công bản hoàn chỉnh và tìm những chỗ cả họ model Claude cùng không thấy.
Chốt tuỳ chọn: /codex:adversarial-review trên code diff
Chốt này chạy sau cook, trước quiz-gate, chỉ khi bạn có gói OpenAI. Các chốt kiểm cố định đều là Claude kiểm Claude: cùng họ model, cùng điểm mù, nên người duyệt khó bắt được lỗi mà chính nó cũng mắc. Chốt kiểm chéo model đưa một model của nhà cung cấp khác vào qua Codex, khử đúng loại unknowns còn lại: unknown unknowns của chính model. Đoạn chỉ hướng lấy từ mục Deviations của impl-notes. Chi tiết ở phần Codex bên dưới.
Chốt 3: /quiz-gate, người kiểm tra người
Đây là chốt cuối trước khi phát hành, khử unknowns của chính bạn về những gì sắp phát hành. Code review bằng máy (hay bằng model khác) đã đạt không có nghĩa là bạn hiểu hết hành vi mới.
Không phải lúc nào cũng chạy đủ pipeline
Mỗi chốt kiểm giống một khoản phí bảo hiểm, nên đóng tương xứng với rủi ro. Chạy đủ giai đoạn 0 tới 5 chỉ dành cho việc vừa ở vùng code lạ, vừa mờ phạm vi, vừa rủi ro cao. Các tình huống hay gặp hơn cần bộ lệnh mỏng hơn.
| Tình huống | Bộ lệnh | Bỏ qua |
|---|---|---|
| Đã có kế hoạch từ session trước, giờ làm tiếp | /ak-watzup đọc trạng thái, đọc mục "Learnings for next session" trong impl-notes cũ, /impl-notes init, /ak-cook giai đoạn tiếp theo, rồi /quiz-gate. Nếu chưa có impl-notes cũ (bạn vừa thêm ba skill này vào một dự án đã dùng AgentKit từ trước) thì bỏ bước đọc mục đó: /impl-notes init tạo file mới trong thư mục kế hoạch đang chạy, bài học tích từ session này | Giai đoạn 0 tới 2, vì unknowns đã được trả phí ở session trước |
| Sửa lỗi nhỏ ở vùng code quen | /ak-fix rồi commit. Nếu phải lệch kế hoạch thì ghi một dòng bằng /impl-notes log | Mọi chốt kiểm. Quiz-gate cho một bản sửa mười dòng là quá liều |
| Vùng code lạ nhưng phạm vi đã rõ | /blindspot <area>, rồi dán prompt tốt hơn thẳng vào /ak-plan | ak-brainstorm, vì phạm vi đã chốt thì không còn gì để bàn |
| Mảng kiến thức hoàn toàn mới (không phải code) | /blindspot --domain (dạy trước, học thuật ngữ), rồi /ak-brainstorm --html | Quét codebase, vì chỗ hổng nằm ở kiến thức, không ở repo |
| Rủi ro cao (giao diện công khai, bảo mật, chuyển dữ liệu) | Đủ pipeline, thêm /ak-predict hoặc /ak-scenario ở giai đoạn 1, red-team rồi validate ở giai đoạn 2, /codex:adversarial-review ở giai đoạn 4 nếu có gói OpenAI. Quiz-gate bắt buộc | Không bỏ gì |
| Claude bị kẹt, sửa đi sửa lại không xong | /codex:rescue (cần gói OpenAI), giao việc cho model của OpenAI nhìn từ góc khác. --resume để nối lại luồng cũ | Đổi chốt kiểm không giải quyết được, vì vấn đề nằm ở điểm mù của model, cần model khác |
| Kế hoạch xong, rủi ro vừa, không đáng huy động cả đội red-team | /ak-plan validate (xác minh và hỏi chốt giả định), rồi /ak-cook | red-team (quá liều cho rủi ro vừa), /ak-predict, /ak-scenario |
| Duyệt PR người khác viết | Chỉ dùng /quiz-gate --pr <n>. Làm quiz chính là cách đọc PR kỹ | blindspot, impl-notes, vì đây không phải code bạn viết |
| Refactor thuần, hành vi không đổi | /ak-code-review và bộ test | quiz-gate không bắt buộc, vì không có hành vi mới để hiểu sai |
Quy tắc chọn: unknowns nhiều thì chốt kiểm dày, unknowns ít thì chốt kiểm mỏng. Chạy đủ pipeline cho việc quen thuộc lãng phí ngang với bỏ chốt kiểm cho việc rủi ro.
Fable 5 nên tham gia công đoạn nào
Bảng dưới ghi theo họ model Claude 5 lúc mình cập nhật bài: Fable 5.1 là tầng mạnh nhất, rồi tới Opus 5.5, Sonnet 5.5 và Haiku 5.5. Chữ "Fable" trong bảng là tầng đó, không phải riêng bản 5.0. Nếu bạn chạy AgentKit trên runtime khác, giữ nguyên nguyên tắc và đổi sang tầng model tương đương của runtime đó.
Chi phí tìm unknowns trả trước thì rẻ. Từ đó suy ra: dồn model đắt nhất vào công đoạn phát hiện và quyết định, dùng model rẻ cho công đoạn thực thi theo chỉ dẫn. Kế hoạch càng tốt thì model triển khai càng được phép rẻ.
| Công đoạn | Model | Vì sao |
|---|---|---|
/blindspot | Fable 5 | Giá trị nằm ở khâu diễn giải: đọc lịch sử git ra "ổ gà", nhận ra commit nào là mẫu đáng theo. Model yếu chỉ liệt kê file. |
/ak-brainstorm, /ak-plan, /ak-predict | Fable 5 | Đây là quyết định kiến trúc. Sai ở đây thì các công đoạn sau rẻ mấy cũng vô ích. |
/quiz-gate (khâu ra đề) | Fable 5 hoặc Opus | Phương án nhiễu tốt đòi hiểu hành vi sâu hơn cả người viết code. Người trả lời là bạn, model chỉ ra đề. |
/ak-plan red-team | Fable điều phối, Opus hoặc Sonnet làm người duyệt | Subagent duyệt chỉ cần tìm kiểu thất bại có bằng chứng file:line, persona đã định sẵn nên Opus là đủ. Khâu phân xử phát hiện mới cần sức nghĩ, chạy ở session chính. Đây là ví dụ rõ nhất trong pipeline về việc chọn model riêng cho từng subagent. |
/ak-plan validate | Sonnet hoặc Opus | Bước xác minh là grep theo checklist, khá cơ học. Phần cần nghĩ nằm ở người trả lời, model chỉ cần hỏi đúng chỗ. |
/ak-cook theo kế hoạch chi tiết | Sonnet | Kế hoạch tốt đã khử unknowns, thực thi chỉ là đi theo bản đồ. Đây là chỗ tiết kiệm lớn nhất. |
/ak-code-review | Opus hoặc Sonnet | Duyệt theo checklist và bằng chứng. Fable chỉ đáng khi thay đổi chạm vào giao diện công khai. |
/impl-notes log, /ak-git, /ak-ship, /ak-watzup | Haiku hoặc Sonnet | Việc cơ học: thêm vài dòng, commit, tổng hợp trạng thái. |
/ak-scout để dò file thô | Haiku | Tìm file bằng Glob, Grep không đáng đốt Fable. Nếu dùng Explore hay subagent để dò diện rộng, ghim model rẻ trước. Blindspot mới là tầng diễn giải ở trên. |
/codex:review, /codex:adversarial-review, /codex:rescue | Model của OpenAI qua Codex (tính vào gói OpenAI riêng) | Chốt kiểm chéo model không đốt token Claude và tách hoá đơn. Giá trị nằm ở điểm mù khác, không phải ở chỗ model mạnh hơn. |
Một cái bẫy về lượng dùng: theo tài liệu Claude Code về subagent dựng sẵn, Explore thừa hưởng model của cuộc hội thoại chính, có một ngoại lệ cho Fable. Dùng gói Claude, tài khoản Anthropic Console hay LLM gateway qua ANTHROPIC_BASE_URL thì Explore tự chuyển sang Opus. Chạy qua Amazon Bedrock, Google Cloud, Microsoft Foundry hay Claude apps gateway thì Explore vẫn ở Fable và đốt lượng dùng Fable. Muốn dò file rẻ mà không ảnh hưởng các subagent khác, tạo một subagent riêng explore.md với name: Explore và ghim model: haiku hoặc model: sonnet.
Kiểu làm nên tránh: dùng Fable để cook nhưng Sonnet để lập kế hoạch. Như vậy là trả tiền model đắt để nó đoán những unknowns lẽ ra phải khử từ trước, đúng cái bẫy bản đồ kém, lãnh thổ đắt mà Thariq cảnh báo.
Codex: đưa model của nhà cung cấp khác vào kiểm Claude
Mọi thứ trong phần này cần gói thuê bao của OpenAI (ChatGPT Plus, Pro hoặc API) và Codex CLI đã đăng nhập. Không có thì bỏ qua cả phần, ba chốt kiểm cố định ở trên vẫn đủ dùng. Các mô tả về hành vi của plugin dưới đây là theo tài liệu và mã nguồn của codex-plugin-cc lúc mình viết bài.
Plugin codex-plugin-cc đưa Codex và model của OpenAI vào Claude Code. Giá trị cốt lõi không nằm ở chỗ model mạnh hơn mà ở chỗ model khác. Mọi chốt kiểm nội bộ đều là Claude kiểm Claude: cùng cách huấn luyện, cùng thiên lệch hệ thống, nên người duyệt khó bắt được lỗi mà chính nó cũng mắc. Codex có điểm mù khác, nên khử được unknown unknowns của chính model.
Cài đặt
/plugin marketplace add openai/codex-plugin-cc
/plugin install codex@openai-codex
/codex:setup
Nếu gọi Codex như một server thay vì qua plugin
Codex CLI cũng có thể chạy như một MCP (Model Context Protocol) server để agent khác gọi vào. Đi đường này thì Claude không còn bị bó trong các lệnh và chốt kiểm của plugin: nó có thể hỏi Codex ở bất kỳ giai đoạn nào, từ brainstorm, lập kế hoạch, cook, duyệt cho tới đóng giai đoạn. Cách này dùng được, nhưng cần rào chắn rõ:
- Khi nào hỏi: chỉ ở những điểm có rủi ro thật, như kế hoạch hệ trọng, code diff đáng kể, bảo mật, chuyển dữ liệu, giao diện công khai, hoặc vòng debug đã thử hai hướng mà vẫn kẹt.
- Hỏi gì: mỗi lần gọi phải có tài liệu hoặc code cụ thể, phạm vi cụ thể, câu hỏi cụ thể, kèm tiêu chí loại những phát hiện không có bằng chứng.
- Tối đa mấy vòng: mặc định một vòng. Vòng hai chỉ khi vòng một dẫn tới thay đổi đáng kể. Không chạy chuỗi hỏi, red-team, duyệt, hỏi lại vô hạn.
- Ai quyết định cuối cùng: Codex không tự duyệt kế hoạch, không tự đóng giai đoạn, không tự cho phép phát hành. Claude hoặc người phải phân xử từng phát hiện, chấp nhận hay bác kèm bằng chứng, rồi mới sửa.
Một session duyệt có quyền rộng hơn (ví dụ mở qua ultracode) chỉ nên duyệt, trừ khi người dùng cho phép sửa, và không nên là đường mặc định vì chạy nhiều vòng rất dễ đốt token. Xem thêm tài liệu OpenAI về Codex và MCP.
Vị trí từng lệnh trong pipeline
| Lệnh | Thời điểm | Vai trò |
|---|---|---|
/codex:adversarial-review trên kế hoạch | Cuối giai đoạn 2, sau red-team và validate | Lớp kiểm chéo model thứ ba trên kế hoạch, chỉ cho trường hợp hệ trọng (chuyển dữ liệu, bảo mật, giao diện công khai) |
/codex:adversarial-review trên code diff | Giai đoạn 4, sau /ak-code-review, trước /quiz-gate | Cách dùng chính mà plugin hướng tới (duyệt trước khi phát hành): chất vấn lựa chọn thiết kế, giả định ngầm, các đánh đổi. Đoạn chỉ hướng lấy từ mục Deviations của impl-notes |
/codex:rescue | Bất kỳ lúc nào Claude bị kẹt | Lối thoát hiểm. --resume giữ luồng Codex riêng theo session |
/codex:review | Giai đoạn 4 | Ý kiến thứ hai khi kết quả /ak-code-review đáng ngờ. Lệnh này không nhận đoạn chỉ hướng nên không dùng cho kế hoạch |
Chốt duyệt tự động (/codex:setup --enable-review-gate) | Mỗi lượt có sửa code | Mặc định tắt, lý do ở bên dưới |
Prompt mẫu: /codex:adversarial-review trên kế hoạch
Codex đứng ở tầng duyệt thứ ba, sau khi kế hoạch đã được rèn qua hai tầng trước. Hãy nói rõ điều đó để nó không đi tìm lại những thứ tầng dưới đã bắt:
/codex:adversarial-review --wait Đây là implementation plan tại plans/<dir>/, chưa phải code, đã qua red-team và validate nội bộ. Đừng verify chi tiết file/symbol. Thay vào đó: (1) challenge HƯỚNG ĐI: đây có phải cách tiếp cận đúng không, có alternative đơn giản hơn không; (2) hidden assumptions mà plan đứng lên trên nhưng không nói ra; (3) tradeoffs bị đánh giá một chiều; (4) pressure-test các phase liên quan [điền risk area thật: auth/data loss/rollback/race].Kế hoạch chưa commit được tính là thay đổi trong working tree (file chưa theo dõi vẫn được duyệt). Kế hoạch đã commit thì thêm --base <ref>.
Vòng xử lý phát hiện: người kích hoạt, không tự động
Lệnh /codex:adversarial-review bị khoá ở chế độ chỉ đọc và trả nguyên văn kết quả. Vòng lặp do người điều khiển:
- Codex chạy vòng 1, trả nguyên văn các phát hiện.
- Claude (Fable hoặc Opus) phân xử: chấp nhận hay bác từng phát hiện kèm bằng chứng. Phát hiện nào trùng với quyết định đã xác minh thì bác và dẫn nguồn.
- Người duyệt danh sách được chấp nhận. Đây là chốt kiểm của người, không bỏ được.
- Claude áp dụng các bản sửa đã duyệt và rà lại cho nhất quán.
- Vòng 2 chỉ chạy khi bản sửa vừa áp dụng là thay đổi đáng kể, với đoạn chỉ hướng trỏ đúng vùng đã sửa. Tối đa hai vòng.
Vì sao không để tự lặp: prompt của Codex trong plugin yêu cầu nó "break confidence in the change, not validate it", tức là tìm cách làm lung lay niềm tin vào thay đổi chứ không xác nhận nó.
Prompt đó vẫn cho phép Codex kết luận là ổn khi không thấy vấn đề, nhưng một người duyệt được dặn đi tìm lỗi thì rất dễ vòng nào cũng tìm ra thêm chuyện để bắt bẻ. Để vòng lặp tự chạy thì rủi ro là nó cứ quay mãi mà không ai quyết định dừng. Vì vậy trong workflow của mình, người là điều kiện dừng, kiểu "phần còn lại là bắt bẻ vụn, đi tiếp". Lưu ý: --resume chỉ có ở rescue. Lệnh /codex:adversarial-review không giữ trạng thái, nên vòng 2 phải tự mang ngữ cảnh trong đoạn chỉ hướng.
Vì sao chốt duyệt tự động mặc định tắt
Phần tự động duy nhất của plugin là một Stop hook duyệt mọi lượt có sửa code. Có ba lý do để tắt nó:
- Mỗi lượt có thể phải chờ rất lâu: theo tài liệu plugin lúc mình viết bài, timeout lên tới 900 giây mỗi lượt. Lượt sửa nào cũng phải chờ duyệt xong mới đi tiếp.
- Mình không thấy cơ chế chặn vòng lặp cứng trong code: chính OpenAI cũng cảnh báo về vòng lặp qua lại giữa Claude và Codex.
- Nghịch lý của việc chặn từng lượt: nó chỉ đáng dùng khi để agent chạy không người canh, nhưng OpenAI lại khuyên chỉ bật khi bạn đang ngồi theo dõi. Mà khi người đang canh thì người đã là chốt kiểm rồi.
Thay vào đó, chạy /codex:adversarial-review một lần ở giai đoạn 4: trả phí một lần, duyệt cả thay đổi ở cuối thay vì từng lượt, và có người phân xử. Đánh đổi là lỗi được phát hiện muộn hơn so với chặn từng lượt.
Bài học từ Alex Finn: thiết kế lại hệ thống làm việc của bạn
Bài của Alex Finn có cùng luận điểm với Thariq nhưng ở tầng cao hơn: thay vì sửa từng tấm bản đồ, hãy nâng cấp cái máy vẽ bản đồ, tức hệ thống làm việc với coding agent của chính bạn. Dưới đây là bốn nguyên tắc mình rút ra, mỗi nguyên tắc kèm một prompt mẫu.
Nguyên tắc 1: dồn Fable vào tầng hệ thống, không phải tầng việc
Một lỗi ở tầng hệ thống bị trả giá lãi kép trên mọi việc. Vì vậy một session Fable dành để thiết kế lại vòng làm việc sẽ được chia đều chi phí cho hàng trăm session cook sau đó. Fable đáng tiền nhất khi kết quả là cấu trúc dùng lại được (hệ thống, skill, kế hoạch), kém đáng tiền nhất khi kết quả chỉ là một lần thực thi.
Thay vì làm ngay task này, hãy thiết kế cho tôi một skill/workflow tái sử dụng để MỌI task cùng loại về sau chạy qua nó. Loại task: [mô tả]. Output cần: quy trình từng bước, file SKILL.md (nếu phù hợp), và tiêu chí đo để biết nó có đang hoạt động tốt không.Nguyên tắc 2: đánh giá từ dấu vết thật thay vì tự kể
Cho Fable đọc thẳng thư mục rules/, các skill và lịch sử git của bạn. Dữ liệu thật về cách bạn làm việc đáng tin hơn nhiều so với lời tự kể: dấu vết phản ánh hành vi thực tế, còn lời kể chỉ phản ánh hình dung của bạn về hành vi đó.
Đừng hỏi tôi làm việc thế nào, lời tự kể không đáng tin. Hãy đọc: thư mục rules/, danh sách skills đang cài, và `git log --oneline -50` của repo này, rồi tự dựng lại bức tranh workflow THỰC TẾ của tôi. Chỉ ra 3 chỗ friction lớn nhất, mỗi chỗ phải cite file hoặc commit làm bằng chứng. Không nhận nhận định không có dẫn chứng.Nguyên tắc 3: kiểm chứng bằng cách chạy thật
Hệ thống mới phải được chạy thử trên một việc thật rồi đo kết quả. Hệ thống chỉ lộ điểm yếu khi chịu tải thật, không lộ trong lúc bàn. Làm bản thử trước, mở rộng sau.
System/skill vừa thiết kế xong: chạy thử nó trên đúng MỘT task thật sau đây: [task]. So sánh với cách làm cũ theo 3 tiêu chí: thời gian, số lần phải sửa lại, chất lượng output. Nếu không hơn rõ rệt, liệt kê chỗ cần chỉnh, đừng khen.Nguyên tắc 4: chỉ thiết kế lại khi một vấn đề lặp lại ba lần
Cùng một kiểu vướng xuất hiện từ ba lần trở lên trong impl-notes, journal hay buổi nhìn lại thì mới đáng thiết kế lại phần hệ thống đó. Vòng lặp là: làm việc, tích luỹ chỗ lệch, nhìn lại thấy mẫu lặp, thiết kế lại, chạy thử, rồi giữ hoặc bỏ.
Đọc implementation-notes.md và journal/retro gần nhất của tôi. Nhóm các deviation/friction theo loại. Loại nào xuất hiện từ 3 lần trở lên? Với MỖI loại đó, đề xuất một thay đổi system NHỎ NHẤT khử được nó. Loại nào dưới 3 lần: bỏ qua, đừng đề xuất gì.Mỗi lần sửa hệ thống nên xuất phát từ một chỗ vướng có thật và được kiểm chứng bằng một lần chạy thật.
Điều cần mang theo
- Tìm unknowns sớm. Chi phí sửa bản đồ trước khi code rẻ hơn nhiều so với sửa lãnh thổ sau khi merge.
- Chốt kiểm dày hay mỏng theo rủi ro. Đủ pipeline cho việc lạ và rủi ro cao, bộ lệnh mỏng cho việc quen.
- Model đắt cho khâu quyết định. Fable 5 cho phát hiện và lập kế hoạch, model rẻ hơn cho thực thi theo kế hoạch đã tốt.
Bộ ba skill blindspot, impl-notes, quiz-gate tải về ở đây: fable5-unknowns-skills.zip.
Đọc tiếp: Guard rail trong Claude Code và AgentKit giải thích các lớp chặn quanh tool call mà những chốt kiểm này dựa vào. Khi nào dùng /ak-plan --deep --tdd nói kỹ về bước lập kế hoạch. OMP Plan mode và AgentKit ak-plan so sánh hai kiểu "plan". Nếu muốn dùng bộ skill của AgentKit cho pipeline này, link đó là link affiliate như đã nói ở đầu bài.
Dùng bài này trong agent của bạn
Lấy API keyChép đoạn dưới, dán vào Claude Code, Codex hay agent bạn đang dùng. Agent đọc bài rồi đối chiếu với repo đang mở.
Đọc bài "Fable 5 và bài toán unknowns: sửa bản đồ trước khi code" trên modernEngineer rồi áp dụng vào repo này.
1. Gọi tool content_get của MCP server modernengineer với locale "vi", slug "fable5-unknowns-workflow". Nếu chưa nối MCP hoặc bị từ chối quyền, đọc thẳng trang https://modernengineer.dev/vi/library/fable5-unknowns-workflow.
2. Tóm tắt các bước chính của bài, chỉ ra bước nào áp dụng được cho repo này.
3. Đề xuất thay đổi cụ thể và hỏi tôi trước khi sửa file.
Nối MCP cho Claude Code (một lần)
claude mcp add --transport http modernengineer \
  https://api.modernengineer.dev/mcp \
--header "Authorization: Bearer <API key>"Bài mở cho mọi người: chưa nối MCP thì agent vẫn đọc được thẳng từ link bài.
- Phiên bản
- v1.0.0
- Cập nhật
- 04/07/2026
- Giấy phép
- Bảo lưu mọi quyền
- Slug
- fable5-unknowns-workflow