Tóm tắt nhanh: Mã ngẫu nhiên và hash cắt ngắn có thể sinh ra mã ứng viên trùng nhau (collision). Ràng buộc
UNIQUE(code)trong database cùng cơ chế thử lại ngăn hai URL được lưu với cùng một mã, và với mã ngẫu nhiên 7 đến 8 ký tự thì số lần thử lại rất ít. Cách này đủ dùng cho phần lớn hệ thống. Nếu muốn mã không bao giờ trùng ngay lúc sinh, mã hoá đầy đủ một ID duy nhất (sequence, dải ID cấp sẵn, Snowflake) sang base62, rồi thêm một phép biến đổi nếu không muốn lộ thứ tự. Dù chọn cách nào,UNIQUEvẫn nên là trọng tài cuối cùng, vì cấu hình sai hay alias tuỳ chỉnh vẫn có thể tạo trùng.
URL shortener là bài tập thiết kế hệ thống quen thuộc. Phần lưu trữ không khó: một bảng code → long_url. Câu hỏi khó là sinh mã ngắn thế nào để hai URL khác nhau không bao giờ nhận cùng một mã.
Bài này đi từ cách làm đầu tiên mà hầu như ai cũng nghĩ tới, chỉ ra nó hỏng ở đâu, rồi mới tới cách tốt hơn. Ở mấy bậc cuối, bậc sau không hẳn tốt hơn bậc trước mà giải một nhu cầu khác, và mình sẽ nói rõ nhu cầu đó là gì. Số liệu trong bài do mình tính và chạy bằng một script Python nhỏ.
Trước hết: không gian mã lớn đến đâu
Phần lớn URL shortener dùng ký tự an toàn trên URL. Base62 là một lựa chọn phù hợp: 10 chữ số, 26 chữ thường và 26 chữ hoa, đều thuộc nhóm ký tự không cần mã hoá trong URL (RFC 3986, mục 2.3). Với độ dài L, số mã có thể có là 62 mũ L:
| Độ dài | Số mã |
|---|---|
| 6 ký tự | khoảng 56,8 tỷ (5,68 x 10^10) |
| 7 ký tự | khoảng 3,52 nghìn tỷ (3,52 x 10^12) |
| 8 ký tự | khoảng 218 nghìn tỷ (2,18 x 10^14) |
Con số này giả định hệ thống phân biệt chữ hoa và chữ thường, và không bỏ mã nào. Nếu bạn loại các chuỗi nhạy cảm, dành riêng prefix hay bỏ ký tự dễ nhầm như 0 và O, không gian thực tế sẽ nhỏ hơn.
Nhìn con số hàng chục tỷ, dễ nghĩ rằng trùng mã là chuyện không cần lo. Bậc đầu tiên dưới đây cho thấy vì sao suy nghĩ đó sai.
Bậc 1: hash URL rồi cắt ngắn
Ý tưởng tự nhiên nhất: lấy MD5 hoặc SHA-256 của URL dài, đổi sang base62 rồi giữ 6 đến 8 ký tự. Cùng một chuỗi URL luôn cho cùng một mã ứng viên, nghe như vừa có mã ngắn vừa tự khử trùng lặp.
Vì sao chưa đủ: hash cắt ngắn trùng sớm hơn trực giác
Với URL bình thường (không có ai cố tình tạo trùng), xác suất hai URL khác nhau cho cùng một hash đầy đủ nhỏ tới mức có thể bỏ qua. Nhưng mã 6 ký tự thì không còn là hash đầy đủ. Khi cắt ngắn, giá trị hành xử như mã ngẫu nhiên trong một không gian nhỏ, và câu hỏi cần đặt ra không phải "mã mới có trùng một mã cụ thể không" mà là "trong n mã đã sinh, có cặp nào trùng nhau không". Đây là bài toán ngày sinh (birthday problem): số cặp tăng theo bình phương của n, nên xác suất có ít nhất một cặp trùng xấp xỉ 1 - e^(-n(n-1)/2N), với N là số mã có thể có.
| Độ dài | n = 1 triệu | n = 100 triệu |
|---|---|---|
| 6 ký tự | 99,98% | gần 100% |
| 7 ký tự | 13,2% | gần 100% |
| 8 ký tự | 0,23% | gần 100% |
Với mã 6 ký tự, chỉ cần 1 triệu link là gần như chắc chắn đã có ít nhất một lần trùng. Để kiểm tra với một hash thật, mình lấy MD5 của 2 triệu URL dạng https://example.com/p/<i>, đổi giá trị hash sang base62 và giữ 6 chữ số base62 cuối. Script ghi nhận 29 lượt sinh gặp mã đã có. Theo mô hình phân bố đều, kỳ vọng số cặp trùng là khoảng 35. Hai đại lượng không hoàn toàn giống nhau (một mã xuất hiện ba lần cho hai lượt gặp nhưng ba cặp), nhưng đủ gần để thấy hash cắt ngắn hành xử như mã ngẫu nhiên. Thí nghiệm này chỉ minh hoạ collision, không đo hiệu năng database.
Vậy là hash cắt ngắn không tránh được trùng. Muốn dùng nó, bạn phải xử lý trùng, và lúc đó lộ ra thêm ba vấn đề:
- Cách cắt. Thí nghiệm của mình lấy 6 chữ số base62 cuối, tương đương lấy giá trị hash chia lấy dư cho 62^6, nên phân bố gần đều. Lấy các ký tự đầu của chuỗi base62 không tương đương, vì chữ số đầu bị giới hạn bởi độ lớn của số. Cắt trực tiếp 6 ký tự từ chuỗi hex của MD5 thì không gian chỉ còn 16^6, nhỏ hơn rất nhiều.
- Thử lại khi trùng. Nếu mã ứng viên đã thuộc về một URL khác, bạn phải đổi đầu vào cho lần thử sau, ví dụ hash
URL + số thứ tự lần thử. Nối một salt cố định không giúp gì, vìhash(URL + cùng salt)luôn ra cùng kết quả và vòng thử lại sẽ chạy mãi. - Khử trùng lặp không còn tự động. Giả sử URL A chiếm mã
x, URL B cũng hash raxnên được cấpysau khi thử lại. Lần sau B được gửi lại, hash vẫn rax. Hệ thống phải kiểm traxđang trỏ tới URL nào, rồi đi tiếp theo chuỗi ứng viên của B (hash(B, 1),hash(B, 2)...) và so URL đã lưu mới tìm ra B đang giữy. Khử trùng lặp vẫn làm được, nhưng cần tra cứu và một quy tắc thử lại ổn định, không còn miễn phí như lúc đầu tưởng.
MD5 cũng đã không còn chống được collision do người khác cố tình tạo (RFC 6151). Nếu người dùng có thể gửi URL tuỳ ý, đừng dựa vào tính chất của MD5 để bảo đảm điều gì.
Kết luận của bậc 1: dù dùng hash, bạn vẫn phải phát hiện trùng và thử lại như với mã ngẫu nhiên. Nếu bạn không thật sự cần mã ứng viên tất định theo URL, sinh thẳng mã ngẫu nhiên giúp bỏ được logic hash và chuỗi thử lại.
Bậc 2: mã ngẫu nhiên, kiểm tra trước rồi mới ghi
Sinh mã base62 ngẫu nhiên bằng bộ sinh số ngẫu nhiên an toàn. Để tránh trùng, cách nghĩ đầu tiên là hỏi database trước: SELECT xem mã đã có chưa, chưa có thì INSERT.
Vì sao chưa đủ: khoảng trống giữa hai câu lệnh
Giữa SELECT và INSERT có một khoảng trống. Hai yêu cầu chạy song song có thể cùng thấy mã còn trống và cùng insert. Ở tải thấp bạn hiếm khi thấy lỗi này, nên nó dễ lọt qua kiểm thử rồi xuất hiện trên production. Thêm một vòng SELECT cũng tốn một lượt truy vấn cho mỗi link mới.
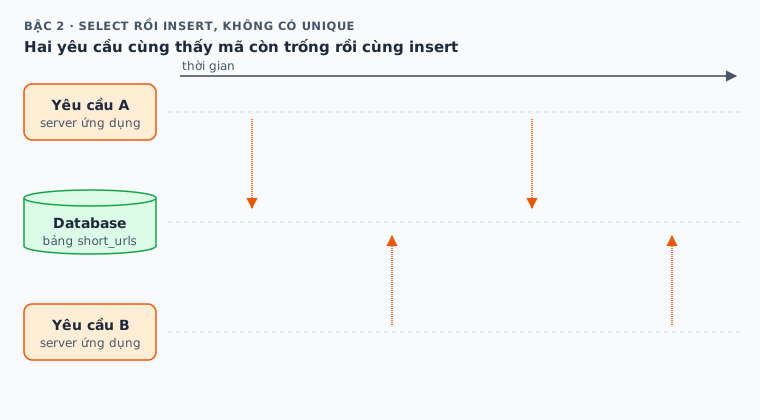
Thứ bảo đảm hai dòng không cùng chiếm một mã phải là một ràng buộc mà database tự thực thi, không phải logic kiểm tra ở ứng dụng.
Bậc 3: mã ngẫu nhiên, UNIQUE và thử lại
Đặt ràng buộc UNIQUE trên cột code và để database làm trọng tài. Ứng dụng không hỏi trước nữa mà insert thẳng; nếu trùng thì sinh mã khác và thử lại. Trong PostgreSQL, viết gọn thành một câu:
insert into short_urls (code, long_url)
values ($1, $2)
on conflict (code) do nothing
returning id;
Đây là truy vấn tham số hoá qua driver, $1 là mã, $2 là URL dài. Nếu không có dòng nào được trả về, mã đã bị chiếm, ứng dụng sinh mã khác và chạy lại (PostgreSQL: INSERT). Unique index chặn được trùng kể cả khi nhiều yêu cầu chạy song song.
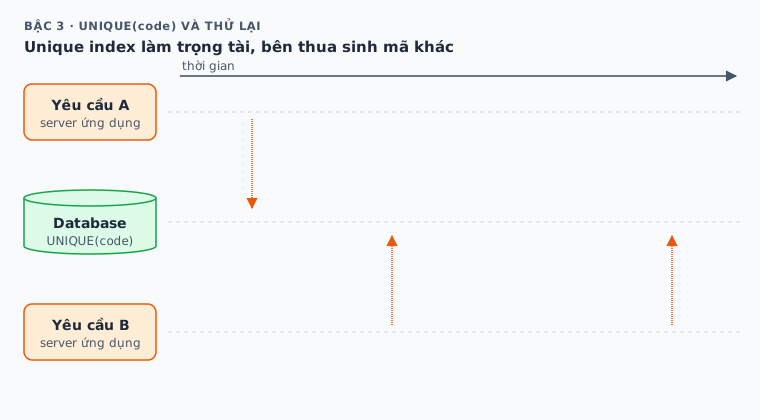
Thử lại có tốn kém không? Bảng xác suất ở bậc 1 nói về toàn bộ lịch sử. Câu hỏi thực tế hơn khi vận hành là: lúc bảng đã có n mã, xác suất một mã mới bị trùng là bao nhiêu? Câu trả lời là n/N:
| Độ dài | Đã có 100 triệu mã | Đã có 1 tỷ mã |
|---|---|---|
| 6 ký tự | 0,18% | 1,76% |
| 7 ký tự | 0,0028% | 0,028% |
Với mã 7 ký tự và 1 tỷ mã đã có, tính ra khoảng 3 lần thử lại trên 10.000 lần tạo link. Trùng chắc chắn sẽ xảy ra, nhưng mỗi lần xảy ra chỉ tốn thêm một câu insert.
Đây là cách mình khuyên dùng cho phần lớn hệ thống: đơn giản, không cần phối hợp giữa các server, và mã ngẫu nhiên từ bộ sinh an toàn không cho người ngoài đoán được mã tiếp theo.
Có nên thêm Bloom filter để khỏi chạm database?
Bloom filter có thể nói "mã này chắc chắn chưa có" mà không cần chạm database, với điều kiện mọi mã đã ghi đều được thêm vào filter đúng cách (Redis: Bloom filter). Nó có dương tính giả, không có âm tính giả. Nhưng kết quả âm không giữ chỗ cho mã: hai yêu cầu vẫn có thể cùng nhận "chưa có", nên lệnh insert vẫn phải đi qua UNIQUE. Khi đã bỏ bước SELECT như trên, thêm Bloom filter chưa chắc tiết kiệm được gì.
Giới hạn của bậc 3
Cách này đủ tốt, nhưng có ba điểm khiến một số hệ thống muốn đi tiếp:
- Không bao giờ bảo đảm không trùng ngay lúc sinh. Tỉ lệ thử lại tăng tuyến tính khi bảng đầy dần. Bạn có thể tăng độ dài mã cho link mới mà không đổi mã cũ, nhưng vẫn phải theo dõi tỉ lệ đó.
- Đoán trúng ngẫu nhiên. Người ngoài không đoán được mã tiếp theo, nhưng thử bừa vẫn trúng một mã đang tồn tại với xác suất xấp xỉ n/N. Nếu link riêng tư, hãy dùng mã dài hơn hoặc kiểm soát truy cập, đừng dựa vào độ ngắn của mã.
- UNIQUE chỉ có hiệu lực trong một database. Nếu sau này chia dữ liệu ra nhiều database độc lập, bạn cần bảo đảm cùng một mã luôn được kiểm tra tại cùng một nơi (ví dụ định tuyến theo
hash(code)), hoặc chia không gian mã thành các miền không giao nhau.
Bậc 4: ID duy nhất rồi mã hoá base62
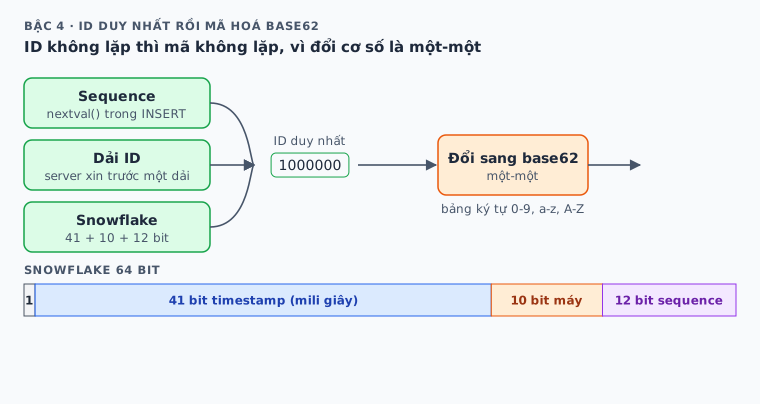
Muốn bỏ hẳn xác suất trùng, đừng sinh ngẫu nhiên nữa. Lấy một số nguyên duy nhất rồi đổi nó sang base62. Phép đổi cơ số là một-một, nên nếu ID không bao giờ lặp thì mã cũng không bao giờ lặp.
Nguồn ID đơn giản nhất là sequence của database: mỗi link mới lấy giá trị tiếp theo.
Khi cần cấp ID mà không hỏi nơi cấp cho từng link
Một sequence nghĩa là mọi lượt tạo link đều lấy số từ cùng một database. Thường đó không phải vấn đề: nextval() có thể gọi ngay trong câu INSERT, và sequence có cơ chế CACHE để giảm chi phí (CREATE SEQUENCE). Mình không đo được sequence là nút nghẽn. Nó chỉ thành vấn đề khi bạn cần sinh ID ở nhiều vùng xa nhau, hoặc đã đo thấy việc cấp ID là chỗ nghẽn. Khi đó có hai cách nới ra, và lưu ý cả hai chỉ bớt việc xin ID, không bớt việc ghi code → long_url xuống database:
- Cấp dải ID (range allocation). Mỗi server xin trước một dải, ví dụ 1.000 số, rồi tự cấp trong RAM, không phải hỏi database cho từng link. Server chết thì phần còn lại của dải bị bỏ phí, thường chấp nhận được.
- Snowflake ID. Twitter công bố năm 2010 (kho mã gốc). ID 64 bit gồm 41 bit timestamp mili giây, 10 bit định danh máy (bản gốc chia 5 bit datacenter và 5 bit worker) và 12 bit sequence trong cùng mili giây. Bảo đảm không trùng chỉ đúng khi mỗi máy có định danh riêng và đồng hồ không chạy lùi; bản gốc từ chối sinh ID khi đồng hồ lùi và chờ sang mili giây sau khi hết sequence (IdWorker.scala).
Snowflake có một cái giá về độ dài: một số 63 bit đổi sang base62 cần tới 11 ký tự, trong khi 7 ký tự base62 chỉ chứa khoảng 41,7 bit. Muốn mã ngắn hơn, bạn phải thiết kế lại cấu trúc bit (ít bit timestamp hơn, ít máy hơn, ít ID mỗi mili giây hơn). Không được cắt bớt chuỗi đã mã hoá rồi vẫn coi là duy nhất, vì cắt ngắn đưa bạn quay về bậc 1.
Vì sao chưa đủ: mã tăng dần nên đoán được
Bậc 4 giải xong bài toán trùng nhưng tạo ra vấn đề mới. Mã sinh từ ID tăng dần, nên người ngoài có thể duyệt lần lượt các link của người khác và ước lượng tốc độ tạo link của bạn. Hiệu hai ID không cho biết chính xác số link đã tạo, vì sequence của PostgreSQL có thể nhảy số khi rollback hay khi ON CONFLICT (tài liệu sequence), và Snowflake còn chứa timestamp và định danh máy. Nhưng xu hướng thì vẫn lộ.
Bậc 5: biến đổi ID để che thứ tự
Giữ nguồn ID duy nhất của bậc 4, nhưng biến đổi nó trước khi thành mã:
- Áp một phép song ánh lên ID rồi mới đổi base62, ví dụ một mạng Feistel với khoá bí mật. Song ánh giữ được tính không trùng. Nhưng song ánh không tự nhiên khó đoán: cộng một hằng số theo modulo cũng là song ánh và rất dễ đảo ngược. Độ khó đoán phụ thuộc vào thiết kế cụ thể và việc giữ khoá.
- Dùng thư viện như Sqids. Sqids nhận số và trả thẳng về chuỗi mã, không phải một bước trước base62. Theo FAQ của Sqids, mã có thể giải ngược, không dùng để bảo vệ dữ liệu nhạy cảm, và chỉ hỗ trợ độ dài tối thiểu chứ không bảo đảm độ dài cố định. Nó làm mã trông không tuần tự, không phải mã hoá bảo mật.
Đến đây bạn có mã không trùng theo thiết kế và không lộ thứ tự một cách hiển nhiên. Cái giá là thêm hạ tầng cấp ID; nếu dùng phép biến đổi có khoá thì còn phải quản lý khoá, còn Sqids chỉ đổi cách biểu diễn ID. Nếu link cần thật sự khó đoán, mã ngẫu nhiên đủ dài của bậc 3 vẫn đơn giản và chắc hơn.
Bậc 6: kho mã sinh trước
Bậc này không sửa thiếu sót của bậc 5. Nó đổi thời điểm sinh mã và cách phân phối mã, và có thể kết hợp với mã ngẫu nhiên hoặc mã từ ID. Ý tưởng là tách việc sinh mã ra một dịch vụ riêng (key generation service). Dịch vụ này sinh sẵn các mã chưa dùng và lưu vào kho. Mỗi server ứng dụng xin một lô mã, giữ trong RAM và cấp dần. Việc sinh mã ra khỏi đường xử lý chính, nhưng vẫn có chi phí lấy lô và ghi database.
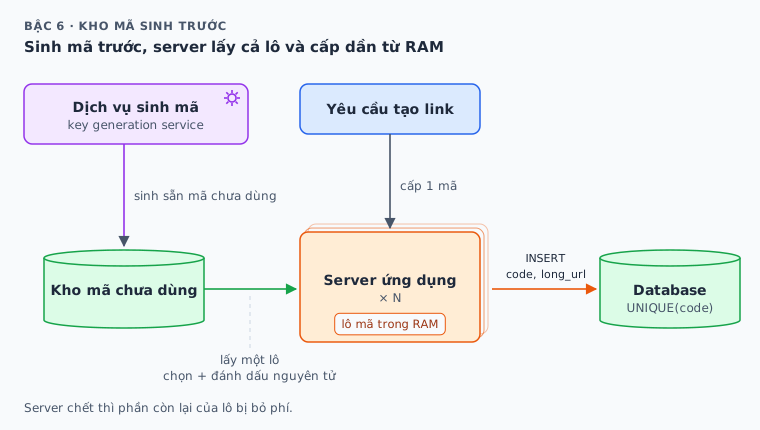
Để không cấp trùng, việc chọn và đánh dấu một lô phải là thao tác nguyên tử và được lưu bền vững trước khi trả lô về cho server, và mỗi mã trong lô chỉ được lấy một lần. Mã đã cấp mà server chết thì bỏ phí. Nếu kho chứa các mã liên tiếp, xáo trộn thứ tự cấp phát không che được tập mã, vì người ngoài vẫn quét được cả dải; kho phải chứa mã ngẫu nhiên đã khử trùng hoặc mã đã qua phép biến đổi ở bậc 5.
Cái giá là thêm một dịch vụ và một trạng thái cấp phát cần vận hành, giám sát. Nó chỉ đáng khi bạn đo được việc sinh mã hay kiểm tra trùng thật sự là nút nghẽn.
So sánh các bậc
| Cách | Mã ứng viên có thể trùng | Có ngăn lưu trùng không | Đoán được không | Phối hợp giữa các server |
|---|---|---|---|---|
| Hash cắt ngắn | Có, theo bài toán ngày sinh | Có, nếu có UNIQUE và thử lại | Ai biết URL thì tính ra mã ứng viên | Không, dựa vào UNIQUE |
| Ngẫu nhiên, SELECT rồi INSERT (không có UNIQUE) | Có | Không, lọt trùng khi chạy song song | Không đoán được mã tiếp theo | Không |
| Ngẫu nhiên + UNIQUE + thử lại | Có, nhưng hiếm | Có | Không đoán được mã tiếp theo | Không, dựa vào UNIQUE |
| ID duy nhất + base62 | Không, nếu ID không lặp | Có, nên giữ UNIQUE | Có | Có: sequence, dải ID hoặc định danh máy |
| ID + phép biến đổi | Không, nếu ID không lặp | Có, nên giữ UNIQUE | Khó hơn, tuỳ phép biến đổi và khoá | Như trên |
| Kho mã sinh trước | Không, nếu cấp lô đúng | Có, nên giữ UNIQUE | Tuỳ kho chứa mã gì | Có, qua dịch vụ cấp mã |
Các quyết định đi kèm, bậc nào cũng gặp
- Cùng URL dài có trả lại mã cũ không. Nếu có, lưu thêm một cột hash của URL dài và đánh index trên nó. Hash chỉ để tìm ứng viên nhanh; muốn chính xác tuyệt đối thì phải so URL gốc. Dưới tải đồng thời, hai yêu cầu cùng URL vẫn có thể tạo hai mã nếu bạn chỉ đọc trước rồi ghi; cần một unique index trên chính khoá khử trùng lặp nếu điều đó quan trọng.
- Mã tuỳ chỉnh do người dùng chọn. Để chung bảng, chung ràng buộc
UNIQUE. Nếu mã tự sinh và mã tuỳ chỉnh dùng chung không gian, mã tự sinh từ ID vẫn có thể đụng một alias người dùng đã chọn trước. Hãy tách không gian (ví dụ alias phải dài hơn hoặc có ký tự riêng) hoặc xử lý conflict cho cả mã tự sinh. - Giữ UNIQUE ở mọi bậc. Kể cả khi thiết kế bảo đảm không trùng, ràng buộc này vẫn bắt được những lỗi bạn không lường trước như cấu hình dải ID chồng nhau hay alias tuỳ chỉnh đụng mã tự sinh.
Nên dừng ở bậc nào
Với hệ thống nhỏ và vừa, bậc 3 với mã 7 đến 8 ký tự thường là đủ. Đi lên bậc 4 và 5 khi bạn cần mã không trùng ngay lúc sinh và đã có hạ tầng cấp ID. Bậc 6 chỉ đáng khi bạn đo được việc sinh mã là nút nghẽn.
Mình không đưa ra ngưỡng số link cụ thể để chuyển bậc, vì bảng n/N chỉ nói về xác suất trùng, không nói về thông lượng hay giới hạn của database.
Câu hỏi thường gặp
Sao không dùng nguyên chuỗi MD5 hay SHA-256 làm mã cho khỏi trùng?
Vì mục tiêu là mã ngắn. Một chuỗi SHA-256 hex dài 64 ký tự, đi ngược với ý tưởng rút gọn. Hash đầy đủ cũng không bảo đảm duy nhất tuyệt đối, và MD5 không còn chống được collision do người khác cố tình tạo. Ngay khi cắt ngắn, bạn quay lại đúng bài toán ngày sinh như mã ngẫu nhiên, nên vẫn cần UNIQUE.
Mã nên dài bao nhiêu ký tự khi bắt đầu?
Với mã ngẫu nhiên có UNIQUE, 7 ký tự base62 cho xác suất mỗi lần insert phải thử lại khoảng 0,0028% khi đã có 100 triệu mã. Nếu muốn dư địa lớn hơn hoặc link cần khó đoán trúng hơn, chọn 8 ký tự.
Sqids có làm mã an toàn không?
Không. Sqids làm ID trông không tuần tự, nhưng mã có thể giải ngược và tài liệu của Sqids nói rõ không dùng nó để bảo vệ dữ liệu nhạy cảm. Nếu link cần riêng tư, hãy dùng mã ngẫu nhiên đủ dài hoặc kiểm soát truy cập.
Vì sao không nên SELECT kiểm tra trước rồi mới INSERT?
Vì giữa hai câu lệnh, một yêu cầu khác có thể chèn cùng mã. Hãy để unique index quyết định bằng INSERT ... ON CONFLICT DO NOTHING RETURNING, rồi thử lại nếu không có dòng nào được trả về.
Dùng bài này trong agent của bạn
Lấy API keyChép đoạn dưới, dán vào Claude Code, Codex hay agent bạn đang dùng. Agent đọc bài rồi đối chiếu với repo đang mở.
Đọc bài "Thiết kế URL shortener: sinh mã ngắn và xử lý collision" trên modernEngineer rồi áp dụng vào repo này.
1. Gọi tool content_get của MCP server modernengineer với locale "vi", slug "url-shortener-collision-strategies". Nếu chưa nối MCP hoặc bị từ chối quyền, đọc thẳng trang https://modernengineer.dev/vi/library/url-shortener-collision-strategies.
2. Tóm tắt các bước chính của bài, chỉ ra bước nào áp dụng được cho repo này.
3. Đề xuất thay đổi cụ thể và hỏi tôi trước khi sửa file.
Nối MCP cho Claude Code (một lần)
claude mcp add --transport http modernengineer \
  https://api.modernengineer.dev/mcp \
--header "Authorization: Bearer <API key>"Bài mở cho mọi người: chưa nối MCP thì agent vẫn đọc được thẳng từ link bài.
- Phiên bản
- v1.0.0
- Cập nhật
- 24/10/2026
- Giấy phép
- Bảo lưu mọi quyền
- Slug
- url-shortener-collision-strategies