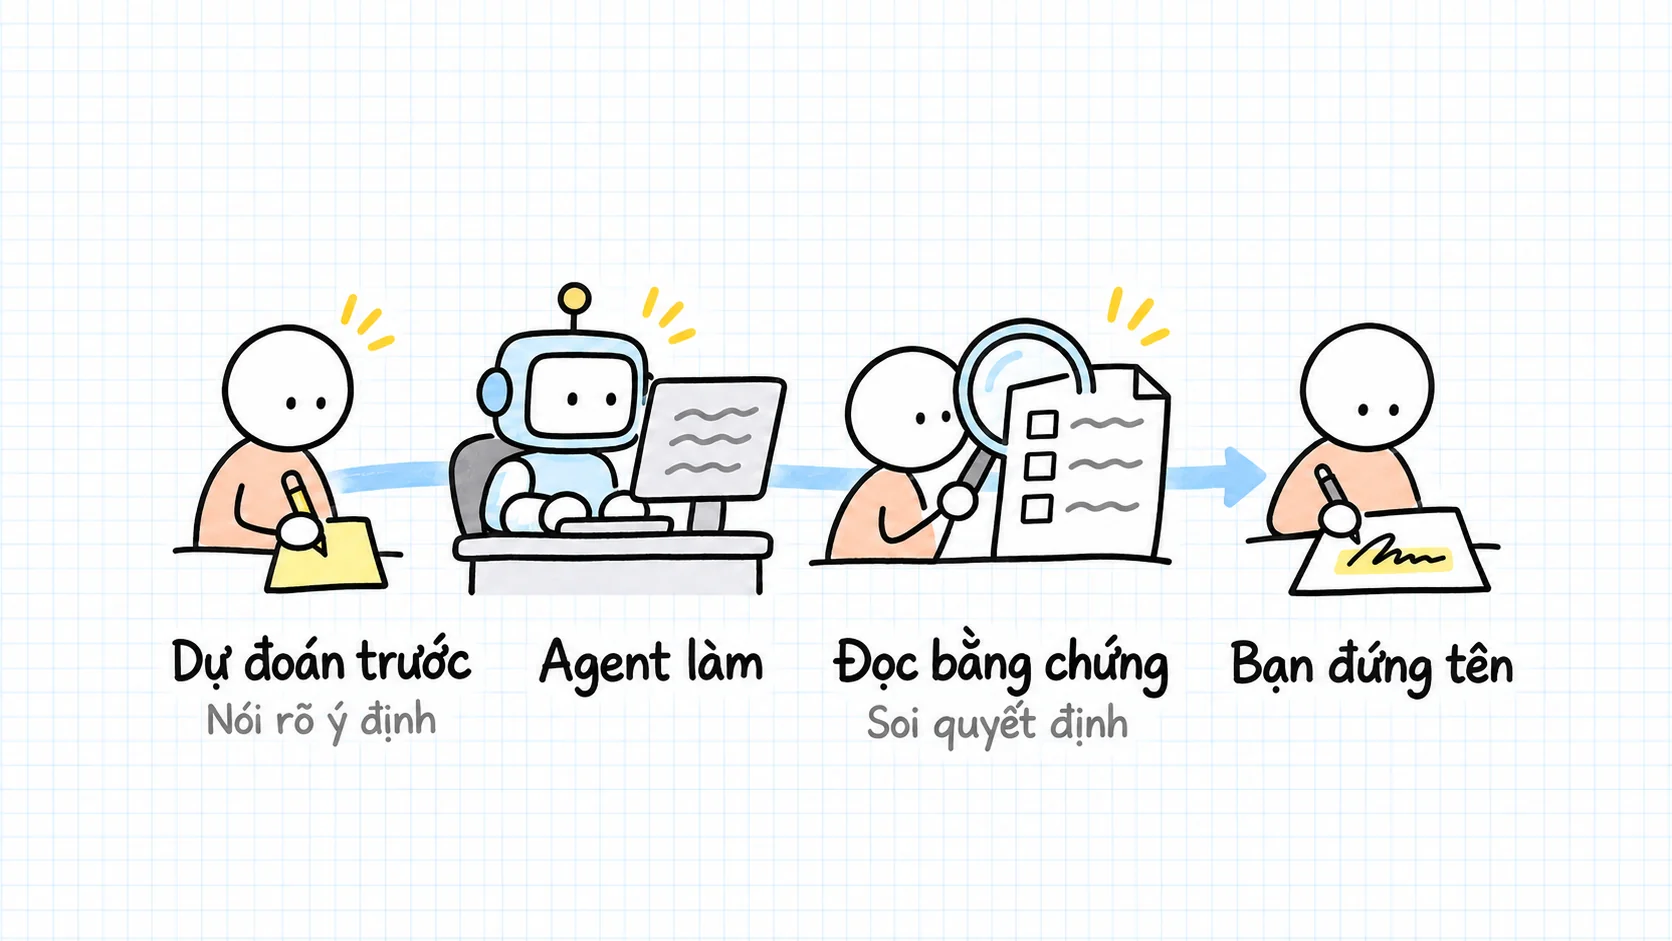
Tóm tắt nhanh: Đầu hàng nhận thức (cognitive surrender) là khi bạn chấp nhận kết quả của AI như kết luận của chính mình mà không thấy cần kiểm lại. Để tránh điều đó, bạn không nhất thiết phải đọc từng dòng code agent viết. Thay vào đó, hãy có dự đoán trước khi hỏi, xác định bằng chứng cần có rồi kiểm bằng chứng trước khi đọc bản tóm tắt. Với những quyết định có thể gây hậu quả cho người khác, phần phán đoán vẫn phải là của bạn.
Trong Critical thinking when agents do the work, Addy Osmani bàn về một vấn đề của những người dùng agent hằng ngày: kết quả càng chỉn chu, càng ít lỗi dễ thấy thì người dùng càng có xu hướng đọc lướt. Ông ủng hộ làm việc với agent và không khuyên dùng ít đi. Điều ông muốn giữ là khả năng tự phán đoán của người giao việc.
Mình phân tích bài này quanh hai câu hỏi: khi nào bạn cần kiểm kỹ và kiểm thế nào để có căn cứ chấp nhận kết quả. Mình sẽ phân biệt rõ đâu là quan điểm của Addy, đâu là nhận xét của mình. Mình bắt đầu bằng việc tách những gì có thể giao hẳn cho agent khỏi những gì bạn vẫn cần tự cân nhắc.
Khi nào bạn cần giữ phần lập luận?
Theo Addy, bạn có thể giao hẳn những quyết định mà nếu sai cũng không gây hậu quả đáng kể. Ông kể chuyện nhờ AI chọn một trong ba khách sạn có mức đánh giá tương đương để quay khoá học. Ông nói sẽ vẫn làm như vậy. Nhưng với những câu hỏi như nên xây sản phẩm gì, thay đổi sẽ ảnh hưởng tới ai hay đã an toàn để phát hành chưa, ông vẫn giữ quyền phán đoán.
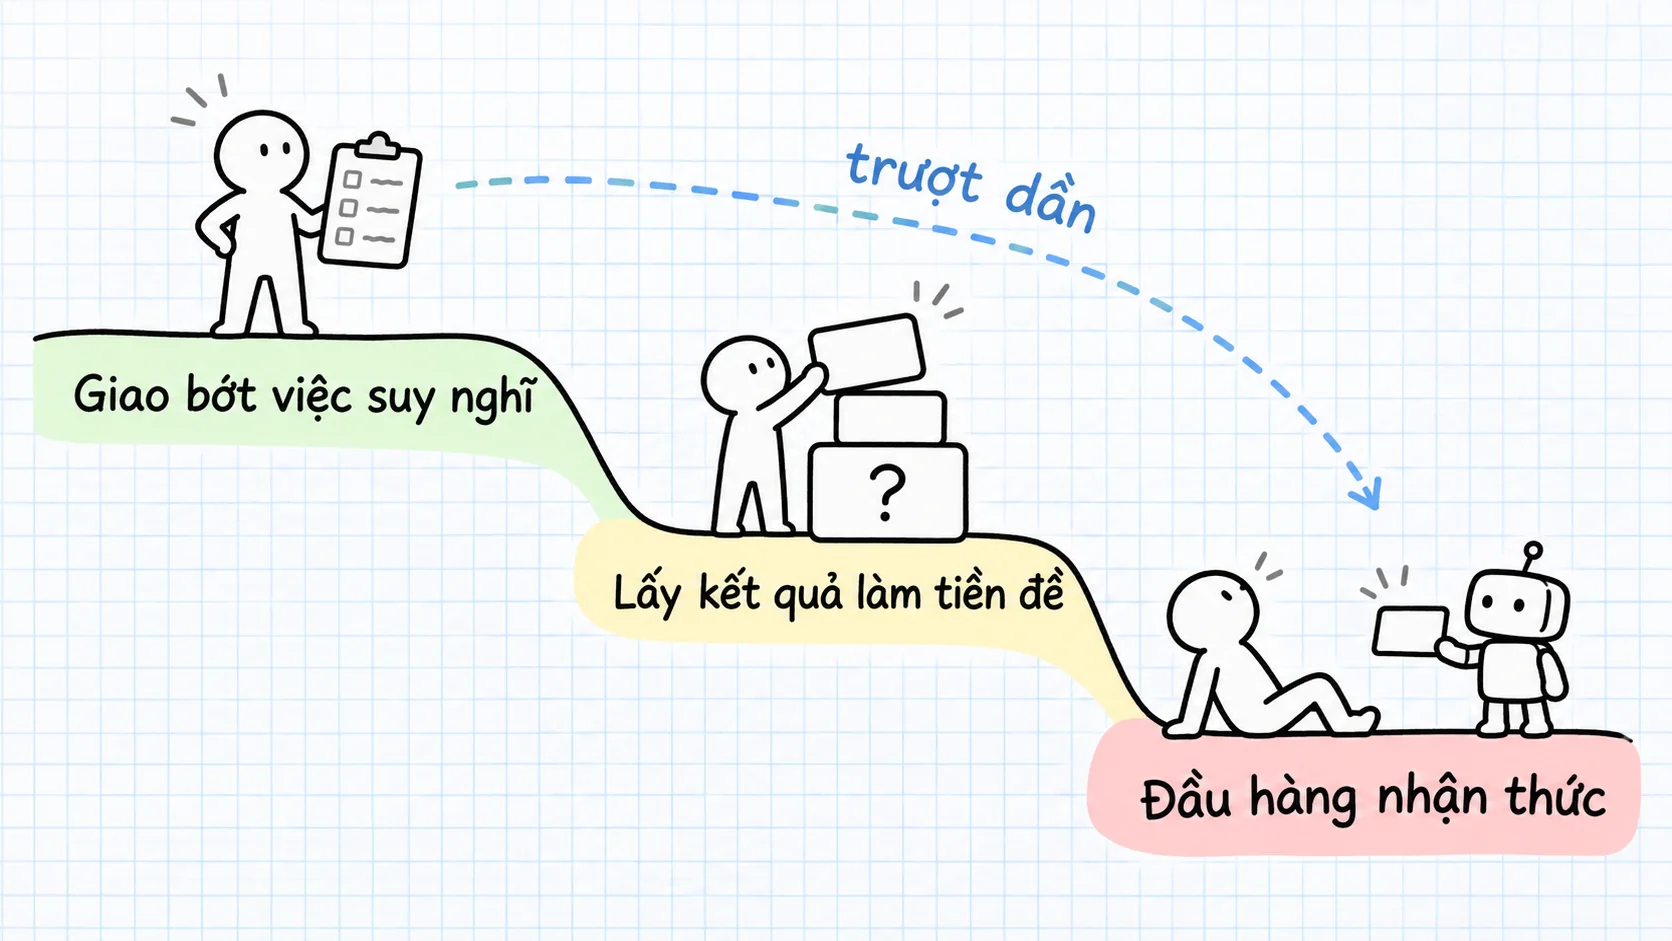
Cùng một người có thể giao việc hợp lý trong tình huống này nhưng lại buông phán đoán trong tình huống khác. Addy mô tả ba mức độ giao việc:
| Mức giao việc | Điều đang xảy ra | Dấu hiệu để tự nhận ra |
|---|---|---|
| Giao bớt việc suy nghĩ (cognitive offloading) | Agent thực hiện công việc, bạn vẫn chịu trách nhiệm về kết quả. | Bạn biết dựa vào đâu để chấp nhận kết quả và có thể giải thích lại khi cần. |
| Lấy kết quả làm tiền đề (deferral) | Bạn dùng kết quả của công cụ làm căn cứ cho bước tiếp theo mà không còn xem đó là giả thuyết cần kiểm. | Bạn tiếp tục công việc dựa trên câu trả lời trước đó dù chưa kiểm tra nó. |
| Đầu hàng nhận thức (cognitive surrender) | Bạn dần chấp nhận kết quả của AI như kết luận của chính mình. | Bạn không thấy cần kiểm lại, hoặc không thể giải thích kết quả ngay cả khi được agent hỗ trợ. |
Mức giữa dễ bị bỏ qua nhất. Chẳng hạn, agent đoán nguyên nhân của một lỗi và bạn lập tức yêu cầu nó sửa theo nguyên nhân đó. Công việc vẫn tiến triển, nhưng một giả thuyết đã được xem như sự thật.
Theo mình, giá trị của cách phân chia này là giúp đổi câu hỏi từ "có nên tin AI không?" thành "với việc này, mình đang giao đến đâu?". Bạn cần kiểm kỹ hơn khi sai sót có thể gây hậu quả đáng kể, khi không giải thích được quyết định hoặc khi chưa biết các phép kiểm hiện có bỏ sót điều gì.
Khả năng giải thích và việc sẵn sàng chịu trách nhiệm là hai cách tự kiểm khá thực tế. Tuy nhiên, theo mình, chúng chưa đủ. Bạn có thể giải thích rất mạch lạc mà vẫn sai. Vì thế, lời giải thích vẫn cần được đối chiếu với bằng chứng.
Trước khi hỏi agent, bạn cần giữ lại những gì?
Addy cho rằng phần suy nghĩ của con người đang chuyển về hai đầu công việc: xác định đúng vấn đề và đánh giá kết quả. Khi yêu cầu còn mơ hồ, agent có thể tự điền những giả định còn thiếu rồi tạo ra một kết quả trông rất hoàn chỉnh. Trong khi đó, đồng nghiệp thường sẽ hỏi lại để làm rõ.
Ông gọi phần mục tiêu, ràng buộc và lý do chưa được nói rõ là nợ ý định (intent debt), trong bài của chính ông được đăng lại trên O'Reilly Radar. Agent có thể giúp bạn làm rõ yêu cầu, nhưng bạn vẫn cần quyết định mục tiêu và những ràng buộc quan trọng.
Trước một nhiệm vụ đáng kể, Addy khuyên bạn tự viết yêu cầu bằng lời của mình: công việc phục vụ ai, điều gì nằm ngoài phạm vi và thế nào mới được coi là hoàn thành. Theo kinh nghiệm của ông, nếu đã sửa tới vòng thứ hai mà kết quả vẫn chưa đúng ý, hãy cân nhắc viết lại yêu cầu thay vì tiếp tục vá từng chi tiết. Đây là lúc nên xem lại cách đặt bài toán, không phải giới hạn cứng. Một phiên gỡ lỗi khó vẫn có thể cần nhiều vòng thử.
Addy đưa ra sáu câu hỏi để tự kiểm phần phán đoán của mình:
- Mình đã có giả thuyết trước khi hỏi chưa? Đoán sai cũng không sao. Theo Addy, một câu trả lời nghe thuyết phục có thể khiến bạn khó nghĩ tới giả thuyết khác. Vì vậy, hãy có một dự đoán của riêng mình trước khi đọc câu trả lời.
- Mình muốn agent giúp suy nghĩ hay suy nghĩ thay? Cả hai cách đều có lúc phù hợp, miễn là bạn biết mình đang chọn cách nào.
- Điều gì, nếu đúng, sẽ khiến kết luận này sai? Hãy tìm một phép thử thực tế cho khả năng đó. Theo Addy, nên dựa vào phép thử có thể chạy được thay vì chỉ tin mức tự tin mà model tự báo.
- Mình đã xem xét ý kiến phản biện chưa? Addy nhờ nhiều model lập luận cho phía đối lập, sau đó tự đưa ra kết luận.
- Mình có dám bảo vệ kết quả trước người phải bảo trì nó không? Hãy tự hỏi liệu bạn có thể giải thích và chịu chất vấn về thứ mình bàn giao hay không.
- Mình đang ít thực hành kỹ năng nào? Có những kỹ năng bạn có thể chấp nhận không còn tự làm thường xuyên, nhưng đó nên là lựa chọn có chủ ý.
Nếu chưa biết bắt đầu từ đâu, bạn có thể nhờ agent đặt câu hỏi để làm rõ yêu cầu. Addy liên hệ cách cộng tác này với Andy Clark trong Extending Minds with Generative AI (Nature Communications, 2025): qua từng lượt trao đổi, bạn hiểu rõ hơn điều mình đang nghĩ và muốn làm. Một cách khác là lượt tìm điểm mù (blind spot pass) mà Thariq Shihipar mô tả. Bạn đưa cho AI những gì mình đã biết, rồi nhờ nó tìm các câu hỏi quan trọng mà mình chưa nghĩ tới.
Khi agent báo xong, nên kiểm gì trước?
Theo Addy, điểm nghẽn đang chuyển từ việc tạo ra kết quả sang việc có đủ căn cứ để tin kết quả đó đúng. Bạn không nhất thiết phải đọc từng dòng code. Quan trọng hơn là thiết lập được cách kiểm và xem xét bằng chứng thu được.
Boris Cherny diễn đạt nguyên tắc này trong bài đăng ngày 02/01/2026: "give Claude a way to verify its work". Khi có cách kiểm như test đầu cuối hoặc thao tác trực tiếp trên ứng dụng, agent có thể tự sửa, chạy test, đọc lỗi rồi thử lại trước khi bạn xem kết quả.
Tuy nhiên, ngay cả việc kiểm cũng có thể bị giao phó quá mức. Ban đầu, bạn hỏi "có bằng chứng không?", nhưng dần dần chỉ nhìn xem test đã xanh chưa. Nếu test và phần triển khai cùng dựa trên một cách hiểu sai yêu cầu, cả hai có thể sai mà test vẫn đạt.
Từ những gợi ý của Addy, có thể rút ra ba việc khi kiểm kết quả:
- Xác định trước cần kiểm những gì mới đủ. Ghi rõ hành vi cần chứng minh và bằng chứng bạn muốn nhận trước khi agent hoàn thành. Nếu đợi có kết quả rồi mới đặt tiêu chí, bạn rất dễ tìm lý do để chấp nhận kết quả sẵn có.
- Xem bằng chứng trước khi đọc bản tóm tắt. Kiểm tra agent đã chạy lệnh gì, đầu ra ra sao. Bằng chứng có thể là kết quả test, ảnh chụp màn hình, log hoặc dấu vết thực thi.
- Hỏi phép kiểm chứng minh được gì và bỏ sót gì. Test đạt chỉ cho biết hệ thống đáp ứng những điều mà test thực sự kiểm tra.
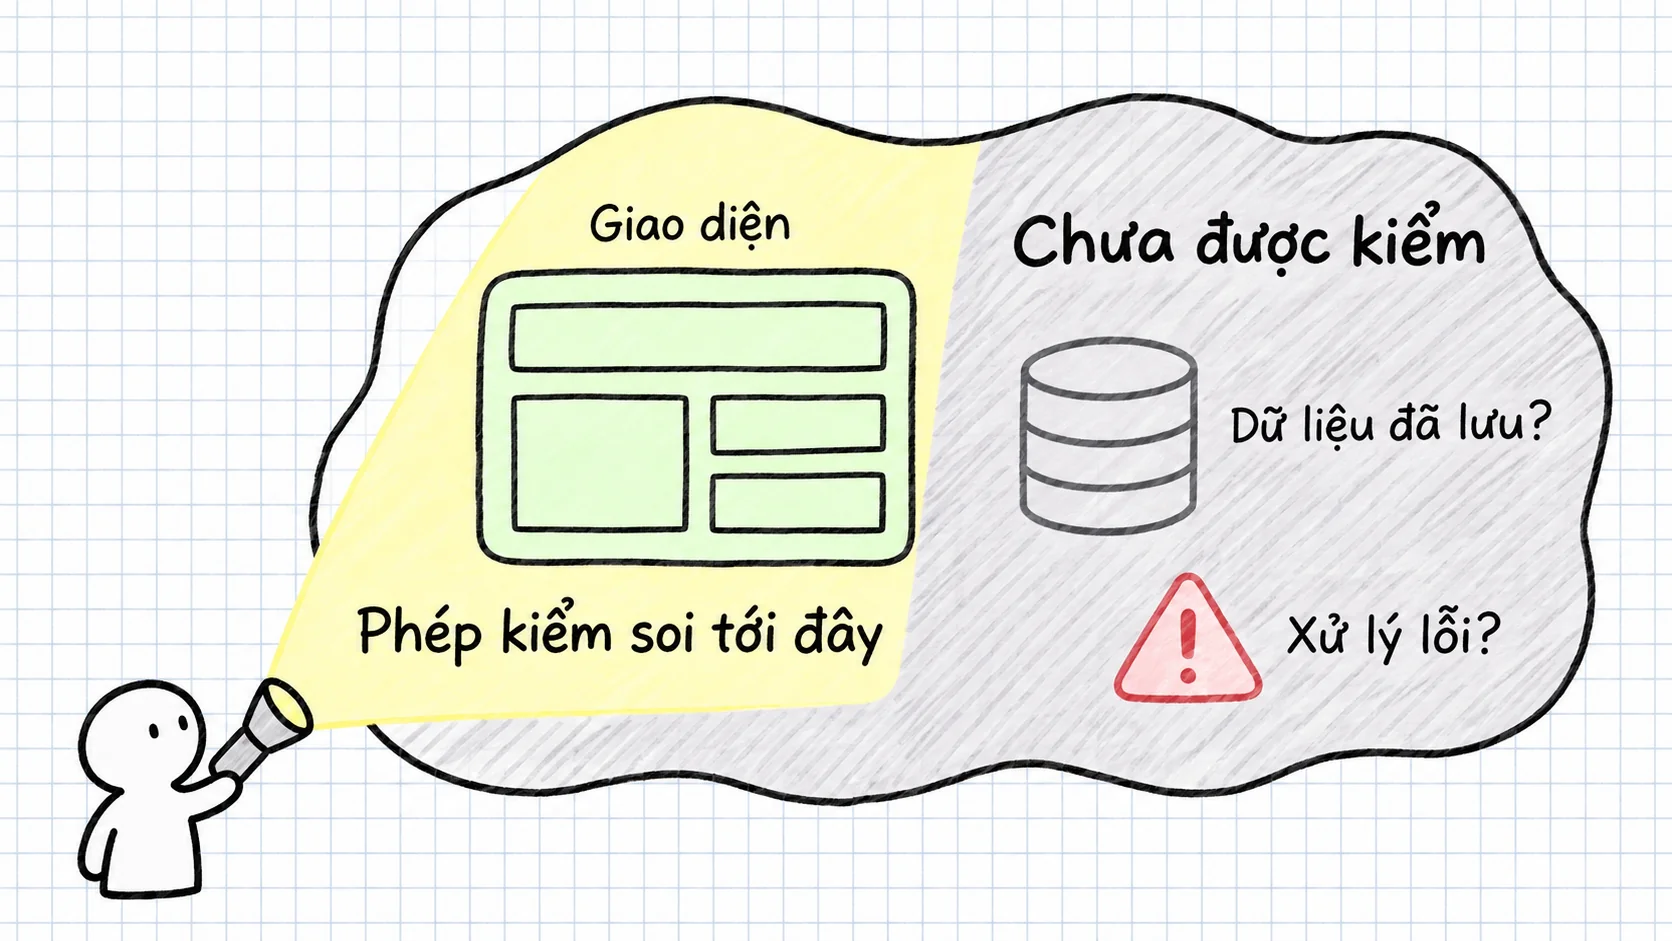
Ví dụ, một ảnh chụp màn hình cho thấy giao diện hiển thị đúng tại thời điểm được chụp. Theo mình, bằng chứng đó chưa đủ để kết luận dữ liệu đã được lưu đúng hoặc ứng dụng xử lý lỗi đúng cách. Bạn cần kiểm những gì liên quan trực tiếp tới kết luận mình định chấp nhận.
Không phải thay đổi nào cũng cần kiểm sâu như nhau. Bài How the Claude Code team does code review nêu một cách chọn mức độ duyệt: nếu không nói được những gì các phép kiểm có thể bỏ sót, hãy yêu cầu một lượt duyệt kỹ thay vì duyệt nhanh. Nếu xác định được giới hạn đó, các phép kiểm hiện có thường đủ cho thay đổi tương ứng.
Nguyên tắc này cũng áp dụng ngoài code. Addy lấy ví dụ agent tổng hợp 50 cuộc gọi khách hàng. Trước khi dùng kết quả để đưa ra khuyến nghị, hãy mở một vài tài liệu gốc và kiểm lại những con số quan trọng. Theo mình, đây là cách đối chiếu có mục tiêu. Một vài mẫu đúng chưa chứng minh toàn bộ nội dung tổng hợp chính xác, nhưng chỉ cần phát hiện một mẫu sai là bạn đã có lý do để kiểm tiếp.
Đọc những quyết định agent đã đưa ra
Test đạt chưa có nghĩa là agent đã hiểu đúng yêu cầu. Bạn còn cần xem những lựa chọn mà agent tự đưa ra trong lúc làm việc, nhất là những lựa chọn không xuất hiện trong bản tóm tắt.
Addy nêu tình huống một pull request (PR) dài 600 dòng. Cấu trúc hợp lý, tên biến rõ ràng, test đạt nên PR được duyệt. Nhưng giữa những thay đổi đó có thể là một chỗ đảo thứ tự xử lý tại ranh giới giao dịch hoặc một giá trị mặc định bị đổi trong trường hợp biên. Nếu chỉ kiểm những gì đã nghĩ tới từ trước, người duyệt rất dễ bỏ qua các thay đổi như vậy.
Ông khuyên đọc phần code thay đổi như thể AI không viết nó, rồi nhìn xa hơn để tìm những quyết định agent đã tự đưa ra. Chẳng hạn, nó chọn giá trị mặc định nào, bỏ phần nào khỏi phạm vi hoặc hiểu lại yêu cầu ra sao khi hai yêu cầu mâu thuẫn. Hãy nhờ agent liệt kê các quyết định và giả định đã dùng, sau đó kiểm kỹ những chỗ có thể gây hậu quả đáng kể.
Để tự kiểm xem mình có thực sự hiểu kết quả không, Addy gợi ý chọn vài dòng code rồi thử giải thích chúng. Với tài liệu, hãy đóng tài liệu lại và viết ra luận điểm chính từ trí nhớ.
Một cách cụ thể hơn được Thariq Shihipar trình bày trong bài hướng dẫn của ông về cách tìm những điều chưa biết khi làm việc với model Claude Fable 5. Thariq nhờ Claude viết báo cáo thay đổi kèm một bộ câu hỏi kiểm tra mức hiểu của mình. Quy tắc ông đặt ra là: "I only merge after I pass the quiz perfectly". Addy dẫn lại thói quen này như một cách làm ông thích.
Theo mình, trả lời đúng bộ câu hỏi giúp bạn biết mình hiểu tới đâu về những phần được hỏi. Nhưng agent cũng chính là bên ra đề. Nếu nó hiểu sai yêu cầu ở một trường hợp biên, bộ câu hỏi có thể bỏ qua trường hợp đó. Bạn vẫn trả lời đúng hết mà lỗi chưa được phát hiện. Trong bài trước, Fable 5 và bài toán unknowns, mình đã dựng hai việc này thành hai skill dùng lại được là /blindspot và /quiz-gate.
Addy cũng dùng agent để lọc PR trong một dự án mã nguồn mở của ông, giúp chỉ ra những chỗ cần chú ý. Tuy vậy, ông hiếm khi để agent tự quyết việc đó. Việc sàng lọc có thể giao đi để dành thời gian của người cho những quyết định quan trọng hơn.
Không nhớ toàn bộ hệ thống có phải đầu hàng không?
Không. Addy nói rõ rằng không ai có thể nhớ toàn bộ một codebase lớn. Bài viết về cách đội Claude Code thực hiện code review cũng kể rằng khi cần hiểu một phần hệ thống, họ nhờ Claude giải thích riêng phần đó.
Khác biệt nằm ở chỗ bạn nhận ra mình chưa hiểu chỗ nào và biết cách tìm lại phần kiến thức đang thiếu. Theo Addy, việc khôi phục hiểu biết về một phần hệ thống có thể dễ hơn nhiều kỹ sư nghĩ, miễn là bạn xác định được mình cần hiểu điều gì.
Ông nhắc tới hai loại nợ thường chỉ bộc lộ khi hệ thống cần được sửa đổi. Margaret-Anne Storey viết về nợ nhận thức (cognitive debt), khi cả nhóm dần mất hiểu biết chung về cách hệ thống hoạt động. Với code, Addy viết về nợ hiểu code (comprehension debt): code trông sạch, test đạt, nhưng khi cần sửa thì không ai hiểu đủ để thay đổi nó.
Theo mình, đây là một giới hạn quan trọng của lời khuyên "hãy hiểu thứ bạn phát hành". Bạn cần hiểu đủ phần hệ thống đang thay đổi, căn cứ để chấp nhận kết quả và hậu quả có thể xảy ra. Không ai bắt bạn nhớ mọi chi tiết của toàn bộ hệ thống. Nhờ agent giải thích là hợp lý, nhưng bạn vẫn cần đối chiếu lời giải thích với code hoặc hành vi thực tế. Nếu không, bạn chỉ đang chuyển từ tin kết quả sang tin lời giải thích.
Model giỏi hơn có làm việc giám sát nhẹ đi?
Bạn có thể giao thêm việc phát hiện lỗi cho agent và Addy ủng hộ hướng đó. Tuy nhiên, việc nên tin agent đến mức nào vẫn cần bạn tự cân nhắc, nhất là khi các kiểu lỗi của model liên tục thay đổi. Cuối cùng, vẫn phải có người chịu trách nhiệm về thứ được phát hành.
Báo cáo How AI is transforming work at Anthropic, dựa trên khảo sát và phỏng vấn nội bộ, gọi đây là nghịch lý giám sát (paradox of supervision). Để giám sát Claude, con người cần những kỹ năng mà chính việc phụ thuộc quá nhiều vào AI có thể khiến họ ít thực hành và dần mai một.
Cũng cần phân biệt bằng chứng nghiên cứu với nhận xét từ thực tế sử dụng. Thuật ngữ đầu hàng nhận thức xuất phát từ nghiên cứu của Steven Shaw và Gideon Nave tại Wharton School, Đại học Pennsylvania (bản trên SSRN). Tóm tắt trên trang hồ sơ của Shaw mô tả ba thí nghiệm đăng ký trước với 1.372 người. Các thí nghiệm dùng một biến thể của bài kiểm tra phản xạ nhận thức (Cognitive Reflection Test), trong đó AI được bí mật thiết lập để trả lời đúng hoặc sai.
Trong nghiên cứu thứ nhất, so với khi không sử dụng AI, độ chính xác tăng khoảng 25 điểm phần trăm khi AI trả lời đúng và giảm khoảng 15 điểm khi AI trả lời sai. Người tham gia có xu hướng đi theo câu trả lời của AI trong cả hai trường hợp.
Bài của Addy là một bài luận dựa trên kinh nghiệm và quan sát, liên hệ kết quả nghiên cứu với cách làm việc thực tế. Theo mình, không nên xem toàn bộ lời khuyên của ông là một quy trình đã được thực nghiệm xác nhận. Kết quả từ bài kiểm tra suy luận cũng chưa đủ để kết luận AI gây ra mức ảnh hưởng tương tự trong công việc kỹ thuật.
Khi lượng việc vượt sức duyệt
Addy gọi khoảng cách giữa lượng việc agent tạo ra và lượng việc bạn yên tâm đứng tên là thuế điều phối (orchestration tax). Khi agent tạo ra kết quả nhanh hơn tốc độ bạn có thể duyệt, lượng việc chờ kiểm cứ tăng lên. Mở thêm phiên agent không giải quyết được nút thắt đó. Ông đề xuất hai hướng: cải thiện các phép kiểm để giảm số việc cần người xem trực tiếp, hoặc chủ động làm chậm lại.
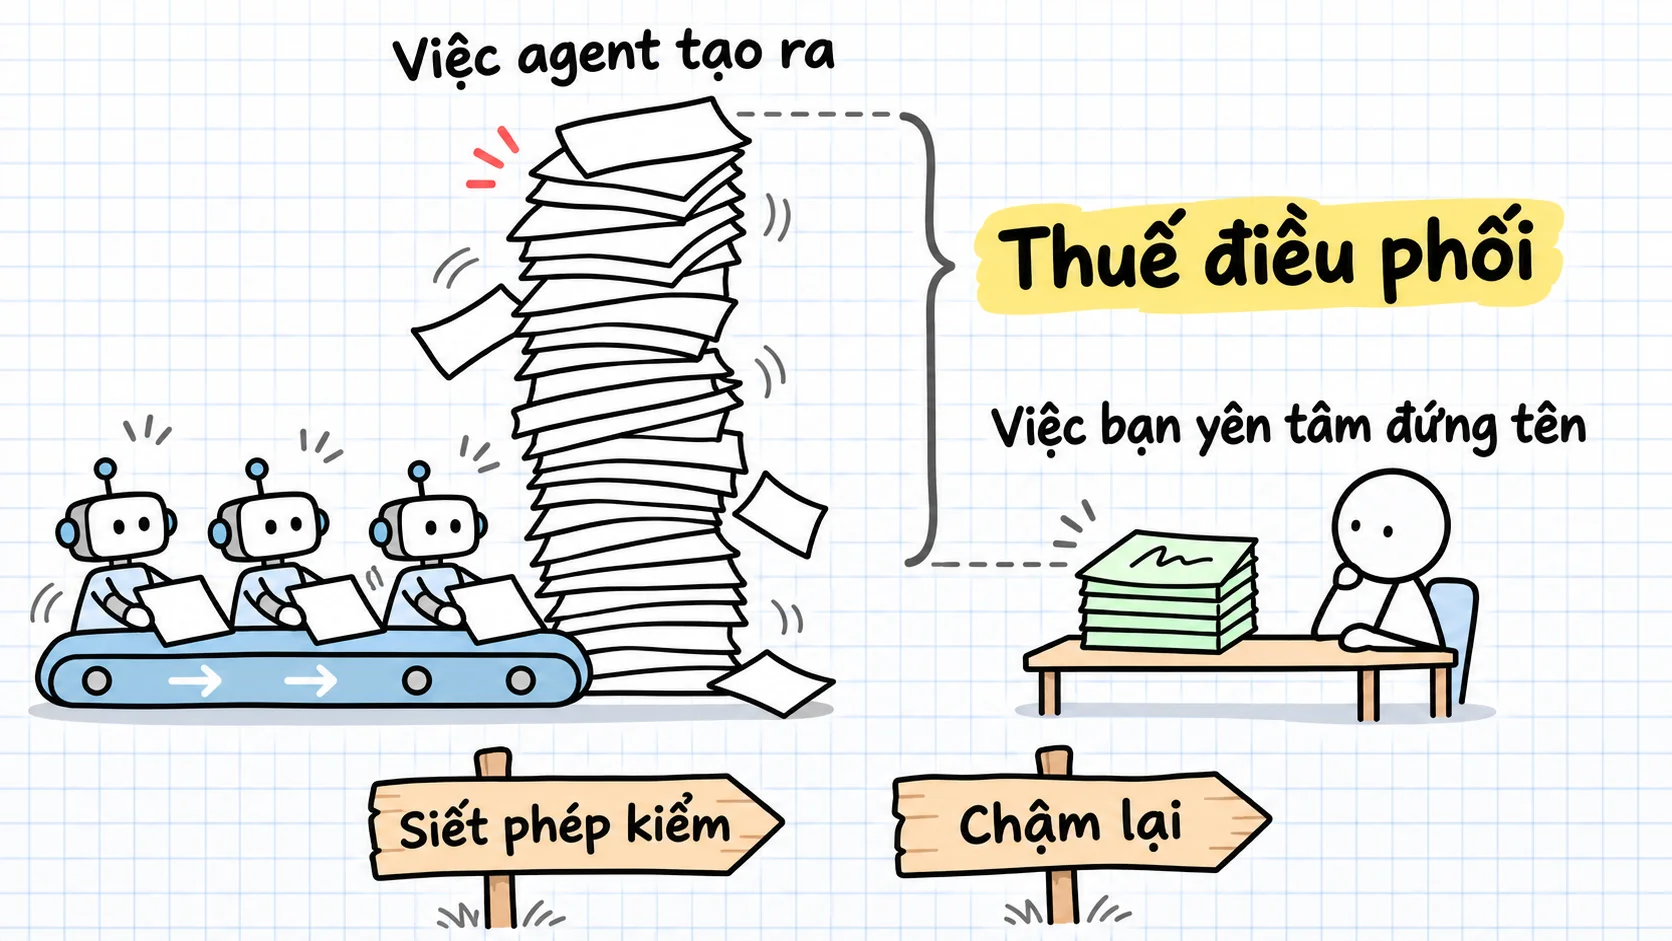
Addy còn gợi ý mỗi tuần tự tay làm một việc mà bạn không muốn quên cách thực hiện. Mỗi tháng, hãy ghi lại những việc mình đã ngừng tự làm rồi quyết định xem kỹ năng nào có thể chấp nhận bỏ bớt. Ông gọi đó là bài tập hiệu chỉnh, không phải bài học đạo đức. Ông cũng nói rõ bạn không cần áp dụng tất cả gợi ý. Biết khi nào cần kiểm kỹ cũng là một kỹ năng.
Theo mình, cần tính cả thời gian dành cho việc kiểm. Ngay cả khi đã có công cụ hỗ trợ, thiết lập phép kiểm và xem xét bằng chứng vẫn tốn công sức. Hãy ưu tiên thời gian đó cho những quyết định có hậu quả đáng kể và những kỹ năng bạn chưa muốn mất.
Câu hỏi thường gặp
Ba câu hỏi dưới đây giúp phân biệt việc giao cho agent làm thay một cách hợp lý với việc buông luôn phần phán đoán của mình.
Giao hẳn cho agent có phải sai không?
Không. Theo Addy, giao hẳn là hợp lý khi hậu quả của sai sót đủ nhỏ, chẳng hạn chọn giữa vài phương án tương đương. Quan trọng là bạn biết mình đang giao cả quyền quyết định và sẵn sàng chấp nhận kết quả của lựa chọn đó.
Test đạt rồi có cần đọc mọi dòng không?
Không nhất thiết. Bạn cần biết các phép kiểm đã chứng minh được điều gì, còn bỏ sót phần nào và agent đã đưa ra những quyết định quan trọng nào. Nếu không xác định được giới hạn của các phép kiểm, bạn nên duyệt kỹ hơn thay vì chỉ dựa vào kết quả test đạt.
Nhờ agent giải thích lại code có còn là tự suy nghĩ không?
Có, nếu bạn dùng lời giải thích để hiểu lại phần code đang xem rồi đối chiếu với code hoặc hành vi thực tế. Sau đó, hãy thử tự giải thích quyết định đã được đưa ra và xác định những chỗ mình vẫn chưa hiểu.
Bắt đầu bằng hai dòng ghi chú
Bài tập cuối của Addy đủ đơn giản để bạn áp dụng ngay trong lần giao việc tiếp theo:
- Trước khi hỏi: Ghi lại điều bạn dự đoán sẽ xảy ra, dù chưa chắc mình đoán đúng.
- Sau khi agent làm xong: Ghi lại một điều agent chưa kiểm.
Hai dòng ghi chú giúp bạn có một dự đoán để đối chiếu với câu trả lời và biết rõ ít nhất một giới hạn của kết quả. Với việc mà sai sót không gây hậu quả đáng kể, bạn có thể chấp nhận giới hạn đó. Nhưng nếu quyết định có thể ảnh hưởng tới người khác, đây chính là chỗ cần kiểm tiếp. Addy kết lại bằng một câu: "You may offload the work and much of the auditing, but not the accountability."
Dùng bài này trong agent của bạn
Lấy API keyChép đoạn dưới, dán vào Claude Code, Codex hay agent bạn đang dùng. Agent đọc bài rồi đối chiếu với repo đang mở.
Đọc bài "Cognitive surrender: giữ tư duy phản biện khi giao việc cho agent" trên modernEngineer rồi áp dụng vào repo này.
1. Gọi tool content_get của MCP server modernengineer với locale "vi", slug "critical-thinking-when-agents-work". Nếu chưa nối MCP hoặc bị từ chối quyền, đọc thẳng trang https://modernengineer.dev/vi/library/critical-thinking-when-agents-work.
2. Tóm tắt các bước chính của bài, chỉ ra bước nào áp dụng được cho repo này.
3. Đề xuất thay đổi cụ thể và hỏi tôi trước khi sửa file.
Nối MCP cho Claude Code (một lần)
claude mcp add --transport http modernengineer \
  https://api.modernengineer.dev/mcp \
--header "Authorization: Bearer <API key>"Bài mở cho mọi người: chưa nối MCP thì agent vẫn đọc được thẳng từ link bài.
- Phiên bản
- v1.0.0
- Cập nhật
- 04/11/2026
- Giấy phép
- Bảo lưu mọi quyền
- Slug
- critical-thinking-when-agents-work