Tóm tắt nhanh: Chưa biết chọn model Claude nào thì bắt đầu ở Opus 5.5, effort
medium. Xuống Sonnet 5.5 khi việc đã rõ phạm vi và dễ kiểm, xuống Haiku 5.5 cho việc đơn giản số lượng lớn và subagent đọc log. Thử Fable 5.2 khi Opus ởhighvẫn chưa đạt, hoặc khi việc rất lớn và nhiều quyết định ràng buộc nhau. Trước khi đổi model, hãy cho model tự kiểm kết quả rồi chỉnh effort.
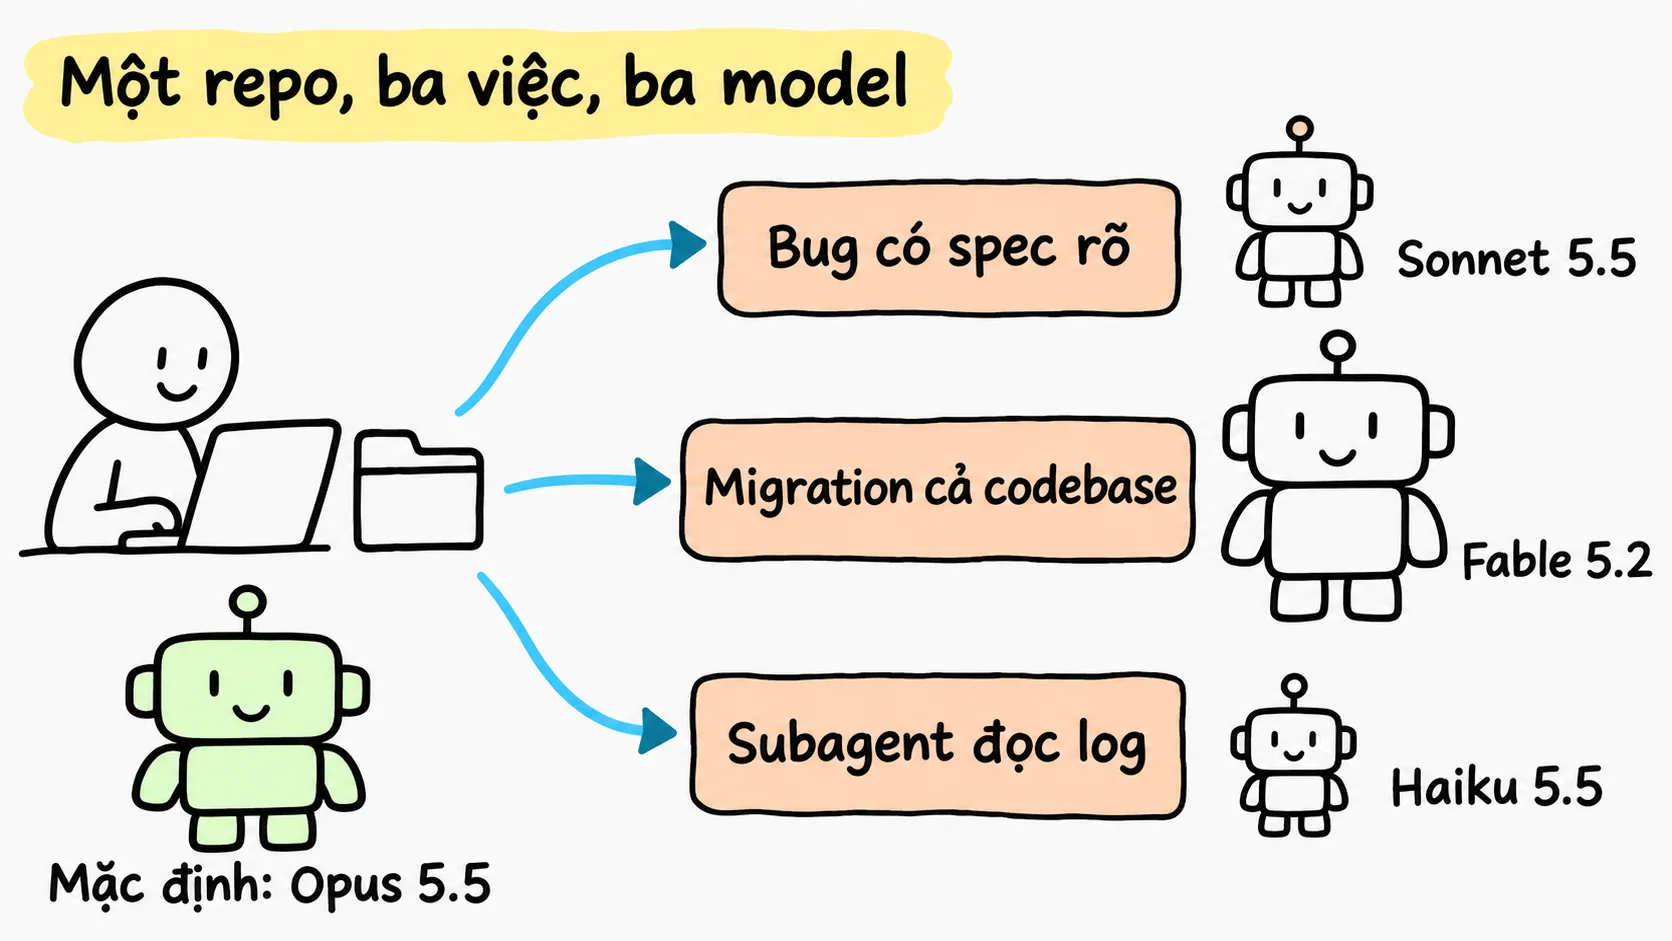
Lấy một ví dụ: hôm nay bạn mở một repo và có ba việc. Sửa một bug đã có spec (bản mô tả yêu cầu) rõ ràng, chuyển cả codebase sang phiên bản framework mới và giao một subagent (agent phụ chạy trong cuộc trò chuyện riêng) đọc log test rồi báo lỗi. Cả ba đều giao được cho coding agent, nhưng không việc nào bắt buộc phải chạy cùng một model với hai việc kia.
Bài này gộp model và effort (mức công sức model bỏ ra cho mỗi lượt) thành một thứ tự quyết định. Số liệu lấy từ tài liệu Anthropic, mình truy cập ngày 11/11/2026, cộng với lịch sử dùng Claude Code của mình. Ba việc trong repo ở trên chỉ là ví dụ minh hoạ, không phải lần chạy thử của mình. Mình đi từ điểm xuất phát trước, rồi tới chuyện khi nào nên rời nó.
Nên bắt đầu ở model nào?
Opus 5.5 ở effort medium. Tài liệu chọn model của Anthropic cũng khuyên phần lớn công việc nên bắt đầu ở Opus 5.5 và coi chỉnh effort thường là đòn bẩy tốt hơn đổi model. Tài liệu đó còn nêu một hướng khác cho việc đơn giản số lượng lớn gọi qua API (Application Programming Interface): bắt đầu ở Haiku 5.5 rồi mới lên.
Có hai lý do thực dụng. Theo tài liệu cấu hình Claude Code, Opus 5.5 là model mặc định của Claude Code trên các gói Pro, Max, Ultra, Team, Enterprise và cả khi bạn chạy Claude Code bằng khóa Anthropic API. Ở bảng giá niêm yết, mỗi token đầu vào và đầu ra của Opus 5.5 rẻ bằng một nửa Fable 5.2.
Bốn model đang bán rộng rãi, mỗi model một dòng:
| Model | Hợp với |
|---|---|
| Haiku 5.5 | Việc đơn giản, số lượng lớn: phân loại, trích xuất, đọc log, tìm file, tóm tắt. |
| Sonnet 5.5 | Việc đã rõ phạm vi và dễ kiểm kết quả: sửa bug có spec, lặp tính năng. |
| Opus 5.5 | Việc kỹ thuật hằng ngày: debug, tính năng trải nhiều PR, việc vừa làm vừa phải quyết định. |
| Fable 5.2 | Việc lớn và mở: refactor lớn, migration, lập kiến trúc, nghiên cứu sâu, dẫn nhiều subagent. |
Bảng này là điểm xuất phát theo loại việc, không phải bảng xếp hạng. Model lớn hơn không bảo đảm giải đúng mọi bài.
Đừng nhầm Mythos 5.2 với Fable 5.2. Hai model có cùng năng lực, nhưng Mythos 5.2 chỉ mở cho tổ chức đã qua chương trình xác minh của Anthropic về an ninh mạng và khoa học sự sống. Với người dùng thông thường, Fable 5.2 là bậc cao nhất chọn được.
Mình đang dùng model nào?
Từ 25/09/2026 đến 10/11/2026, lịch sử Claude Code trên máy mình ghi lại số lượt model trả lời như sau. Một lượt là một thông điệp model trả về trong lịch sử, đã bỏ bản ghi trùng:
| Model | Lượt trả lời | Tỷ lệ |
|---|---|---|
| Opus 5.5 | 85.691 | 87,6% |
| Fable 5.1 và 5.2 | 5.566 | 5,7% |
| Sonnet 5.5 và 5 | 4.651 | 4,8% |
| Haiku 5.5 và 4.5 | 1.961 | 2,0% |
Gần chín trên mười lượt của mình nằm ở Opus 5.5. Fable chỉ chiếm một phần nhỏ số lượt trả lời.
Con số này có giới hạn rõ. Nó là thói quen của một người trên một máy, tính trên mọi dự án trong Claude Code. Nó không đo chất lượng kết quả, không so cùng một việc trên hai model và không phải tỷ lệ mình khuyên bạn theo. Mình cũng chưa tự chạy benchmark hay đo chi phí từng việc. Mọi số đo benchmark trong bài là do Anthropic chạy và công bố.
Việc nào xuống Sonnet hay Haiku, việc nào lên Fable?
Xuống model nhỏ khi phạm vi việc rõ, kết quả dễ kiểm và làm lại không đắt. Lên model lớn khi việc có nhiều quyết định ràng buộc nhau, hoặc model hiện tại vẫn hỏng dù đã có đủ công cụ để tự kiểm.
Bảng dưới là điểm khởi đầu theo loại việc, mình diễn đạt lại từ bài hướng dẫn chọn model của Anthropic ngày 09/11/2026. Effort được chọn cùng lúc với model.
| Việc | Model khởi đầu | Effort khởi đầu |
|---|---|---|
| Việc kỹ thuật hằng ngày, debug, tính năng trải nhiều PR | Opus 5.5 | medium, rồi high |
| Code đã rõ phạm vi: sửa bug, lặp tính năng, làm theo spec | Sonnet 5.5 | medium, rồi high |
| Subagent tìm file, đọc log, tóm tắt | Haiku 5.5 hoặc Sonnet 5.5 | Mặc định của model |
| Phân loại, định tuyến, gắn nhãn, trích xuất số lượng lớn | Haiku 5.5 | medium |
| Chat và session tương tác | Sonnet 5.5, hoặc Haiku 5.5 nếu đơn giản và nhiều | low hoặc medium |
| Việc agent lặp lại: điều tra, duyệt code, soạn nháp | Sonnet 5.5 | medium |
| Tài liệu, slide, bảng tính thường ngày | Sonnet 5.5, Opus 5.5 cho mô hình tài chính phức tạp | high trên API, medium trong Claude Code |
| Điều khiển máy tính (computer use) và việc nặng về hình ảnh | Opus 5.5 | medium |
| Refactor lớn, migration, lập kiến trúc, dẫn nhiều subagent | Fable 5.2 | medium, rồi high |
| Nghiên cứu sâu, phân tích khoa học hoặc định lượng | Fable 5.2 | medium, rồi high |
| Chưa chắc việc khó tới đâu | Opus 5.5 | medium |
Áp vào ví dụ ba việc: bug có spec rõ bắt đầu ở Sonnet 5.5, migration cả codebase bắt đầu ở Fable 5.2, subagent đọc log bắt đầu ở Haiku 5.5 và đổi sang Sonnet 5.5 nếu bản tóm tắt của Haiku thiếu ý.
Có hai chỗ dễ áp máy móc. Spec rõ không tự động nghĩa là Sonnet đủ: nếu bug nằm ở phần hệ thống có nhiều phụ thuộc khó thấy, Opus vẫn là lựa chọn an toàn hơn. Ngược lại, không phải migration nào cũng cần Fable: một bản nâng cấp nhỏ, có hướng dẫn và test chạy được thì bắt đầu ở Opus là đủ.
Nếu phần khó nhất trong việc của bạn là chưa biết mình còn thiếu thông tin gì trước khi viết code, mình có viết riêng về cách dồn model mạnh vào khâu đó trong bài Fable 5 và bài toán unknowns: sửa bản đồ trước khi code.
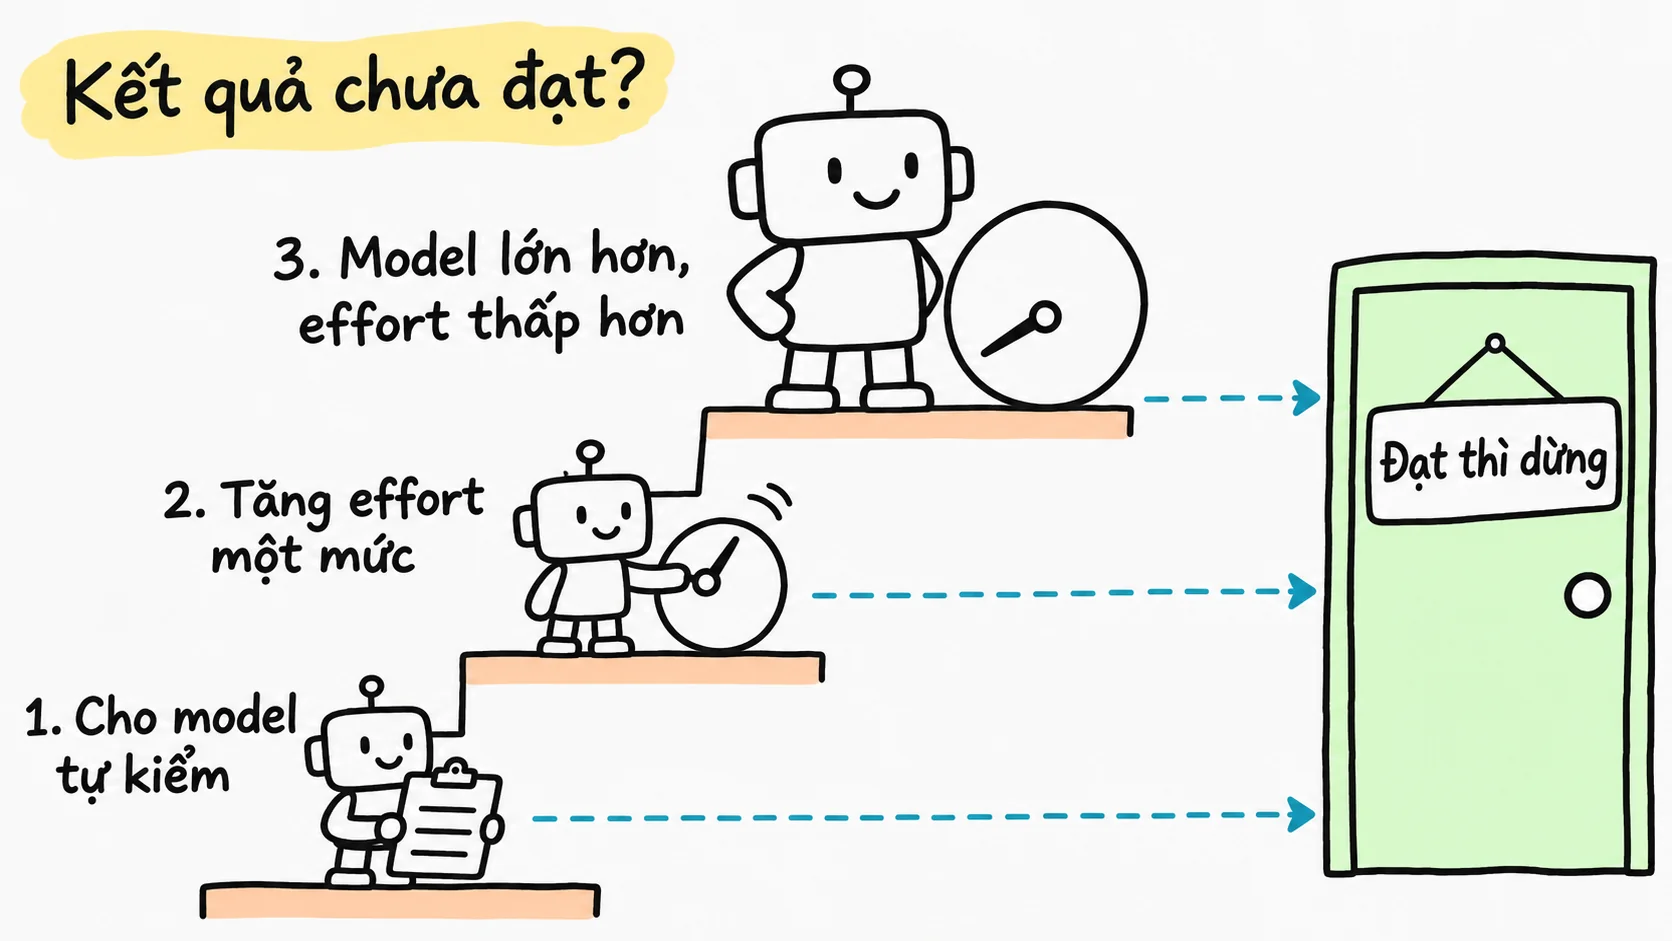
Kết quả chưa đạt thì tăng effort hay đổi model?
Đi theo ba bước, đúng thứ tự:
- Cho model tự kiểm được việc của nó bằng test, build hoặc script.
- Tăng effort một mức.
- Đã ở
highmà vẫn chưa đạt thì thử model lớn hơn ở effort thấp hơn, trước khi đẩy model hiện tại lênxhighhaymax.
Bước 1 đứng đầu vì, theo bài hướng dẫn của Anthropic, nó thường rẻ và nhanh hơn tăng effort. Model chạy được test thì tự thấy mình sai ở đâu, còn tăng effort chỉ khiến nó bỏ thêm công vào một việc vẫn không có cách kiểm.
Effort là gì và mặc định ở mức nào?
Effort không phải thời gian model được ngồi nghĩ. Theo tài liệu effort, nó điều chỉnh tổng lượng việc model bỏ ra cho mỗi lượt. Bài hướng dẫn của Anthropic nói thêm: tăng effort làm lượt chạy lâu hơn, nhưng không thêm kiến thức hay kỹ năng cho model. Nó cũng không bù được thông tin còn thiếu trong yêu cầu.
Cả bốn model đều có năm mức: low, medium, high, xhigh, max. Dễ tưởng medium là mặc định ở mọi nơi. Điều đó chỉ đúng trong Claude Code:
| Model | Mặc định trên Claude API | Mặc định trong Claude Code |
|---|---|---|
| Haiku 5.5 | medium | medium |
| Sonnet 5.5 | high | medium |
| Opus 5.5 | medium | medium |
| Fable 5.2 | high | medium |
Hệ quả thực tế: nếu bạn đem một việc từ Claude Code sang code gọi API mà không truyền effort, Sonnet 5.5 và Fable 5.2 sẽ chạy ở high, cao hơn mức bạn quen.
Trong Claude Code, bạn xem và đổi effort bằng các lệnh sau, gõ vào ô nhập của Claude Code. Bốn lệnh này độc lập, không phải chạy lần lượt:
/effort
/effort high
/effort status
/effort auto
/effort không kèm tham số mở thanh chọn. /effort status cho biết mức đang dùng. /effort auto xóa mức bạn đã đặt để quay về mặc định của model. Mức gõ sau /effort được lưu làm mặc định cho các session sau, trừ max. Chỉ muốn đổi cho session hiện tại thì mở /effort rồi bấm s.
Tăng effort có đáng tiền không?
Trong phép đo dưới đây của Anthropic thì có, tới high. Từ đó trở lên mỗi điểm phần trăm đắt hơn hẳn.
Anthropic đo Opus 5.5 trên một tập con 478 bài của SWE-bench Pro và công bố trong tài liệu tối ưu chi phí và năng lực:
| Effort của Opus 5.5 | Tỷ lệ giải được | Chi phí mỗi bài |
|---|---|---|
low | 87,4% | $0,11 |
medium | 92,8% | $0,21 |
high | 95,3% | $0,29 |
xhigh | 96,7% | $0,74 |
Từ medium lên high, bạn được thêm 2,5 điểm với giá từ $0,21 lên $0,29. Từ high lên xhigh, bạn chỉ được thêm 1,4 điểm nhưng trả gấp khoảng 2,5 lần. Mức xhigh chỉ có một lần chạy, các mức còn lại là trung bình hai lần.
Đây là số đo nội bộ, chạy trong môi trường đánh giá riêng của Anthropic, giới hạn 16.384 token mỗi lượt, thực hiện ngày 19 và 20/09/2026. Anthropic ghi rõ không so được các tỷ lệ này với bảng xếp hạng SWE-bench Pro công khai.
Cũng trong tài liệu đó có một cách dùng effort đáng thử hơn: chạy mọi bài ở low trước, rồi chỉ chạy lại những bài hỏng ở high. Cách này giải được từ 96,4% đến 97,5% với khoảng $0,17 mỗi bài. Chạy tất cả ở high ngay từ đầu giải được 95,3% với $0,29. Điều kiện để làm theo là bạn phải có phép kiểm cho biết bài nào hỏng. Đó là lý do bước 1 đứng trước bước 2.
Khi nào thử model lớn hơn?
Khi model hiện tại đã ở high mà vẫn hụt. Lúc đó model lớn hơn ở effort thấp hơn có thể cho kết quả ngang với chi phí thấp hơn, nhưng không phải lúc nào cũng vậy.
Theo bài công bố Fable 5.2, trong thử nghiệm ban đầu trên FrontierCode 2.0, Fable 5.2 ở high đạt 45,3%, gần bằng Opus 5.5 ở max với 45,5% và tốn khoảng một nửa chi phí mỗi bài. Con số "một nửa" là của Anthropic. Mình không tính lại được vì bài không đưa chi phí gốc.
Một phép đo khác của Anthropic cho kết quả ngược lại. Trên 463 bài của tập SWE-bench Pro ở trên, Opus 5.5 ở xhigh giải 96,5% với $0,75 mỗi bài giải được. Fable 5.2 ở high giải 96,3% với $1,39. Điểm của hai model gần nhau, còn Opus tốn hơn một nửa chi phí của Fable một chút. Anthropic lưu ý hai bên chỉ chung tập bài, không chung cách chấm: Fable được chấm trong môi trường không có mạng, Opus thì có, và chi phí của Fable là số ước tính.
Hai tài liệu của Anthropic cũng đặt ngưỡng khác nhau. Bài hướng dẫn ngày 09/11 nói lên Fable khi Opus ở high vẫn hụt. Tài liệu chọn model nói chuyển sang Fable 5.2 khi phép đánh giá của bạn ở xhigh hoặc max vẫn chưa đạt. Mình hiểu hai ý đó như sau: Opus ở high hụt là lúc nên chạy thử Fable trên chính việc đó, còn đổi mặc định sang Fable thì chờ tới khi Opus ở mức cao hơn cũng không đạt.
Quay lại ví dụ. Với bug có spec rõ, cho Sonnet chạy test trước. Vẫn hỏng thì lên high, rồi mới sang Opus ở medium. Với migration: nếu đó là bản nâng cấp nhỏ bạn đã bắt đầu ở Opus mà ở high vẫn cứ vấp ở các quyết định kiến trúc, hãy chạy thử Fable ở medium trên cùng phần việc đó rồi so kết quả.
Bốn model chênh nhau bao nhiêu về giá và giới hạn?
Mỗi bậc đắt gấp đôi bậc dưới ở token đầu vào và đầu ra, trừ Haiku 5.5 rẻ hơn Sonnet 5.5 tới 20 lần với prompt ngắn. Nhưng hai chi tiết làm tỷ lệ đó không cố định: Haiku đổi giá theo độ dài prompt và cache read của Fable bằng đúng của Opus. Cache read là phần đầu vào model đọc lại từ prompt cache, tức bộ nhớ lưu phần đầu cuộc trò chuyện để khỏi xử lý lại.
Giá niêm yết Claude API, USD cho mỗi triệu token, theo trang giá của Anthropic, truy cập ngày 11/11/2026:
| Model | Đầu vào | Đầu ra | Cache read |
|---|---|---|---|
| Haiku 5.5, prompt tới 100K token | $0,10 | $0,50 | $0,01 |
| Haiku 5.5, prompt trên 100K token | $0,50 | $2,50 | $0,05 |
| Sonnet 5.5 | $2 | $10 | $0,10 |
| Opus 5.5 | $4 | $20 | $0,20 |
| Fable 5.2 | $8 | $40 | $0,20 |
Về giới hạn thì bốn model giống nhau: context window (cửa sổ ngữ cảnh) 1 triệu token và tối đa 128K token đầu ra mỗi lượt gọi API đồng bộ, theo bảng thông số model.
Haiku rẻ nhất, với điều kiện prompt ngắn
Mốc 100K token của Haiku 5.5 tính trên toàn bộ đầu vào của một yêu cầu, gồm cả phần đọc và ghi cache. Vượt mốc thì cả yêu cầu tính giá cao, kể cả phần lấy từ cache. Giá đầu vào khi đó gấp năm lần, dù vẫn chỉ bằng một phần tư Sonnet 5.5.
Vì vậy với subagent luôn phải đọc prompt dài, đừng so đơn giá. Hãy so chi phí cho mỗi việc làm xong.
Trong session dài, gần hết đầu vào là cache read
Cache read rẻ hơn nhiều so với đầu vào mới. Trong một session dài, gần như toàn bộ đầu vào là loại này.
Lịch sử của mình cho thấy điều đó. Trên Opus 5.5, trong cùng khoảng 25/09 đến 10/11/2026, có 18,64 tỷ trên tổng 19,10 tỷ token đầu vào là cache read, tức khoảng 97,6%. Con số này không nói mình tiết kiệm được bao nhiêu tiền, vì mình chưa đo chi phí từng việc. Nó chỉ cho thấy tính theo số token, gần hết đầu vào là cache read. Tính theo tiền thì khác: 2,4% còn lại gần như toàn là phần ghi cache, đắt gấp 25 đến 40 lần cache read trên Opus 5.5, nên vẫn chiếm một phần đáng kể hóa đơn đầu vào.
Từ đó có hai hệ quả:
- Lên Fable, phần cache read không đắt thêm: vẫn $0,20 mỗi triệu token. Phần đắt gấp đôi là đầu vào mới, phần ghi cache và đầu ra. Tổng chi phí mỗi việc thì vẫn có thể tăng hơn gấp đôi, vì Fable có thể dùng lượng token khác hẳn. Trong phép đo SWE-bench Pro của Anthropic, mỗi bài giải được tốn $1,39 trên Fable 5.2 ở
high, so với $0,30 trên Opus 5.5 ởhigh. Hai con số này cũng chịu giới hạn về cách chấm đã nêu ở mục trước. - Ngữ cảnh càng phình thì mỗi lượt càng đắt. Theo bài tính chi phí một việc trên Opus 5.5, mỗi lượt đọc lại 150K token ngữ cảnh tốn khoảng $0,03, còn 20K token chỉ khoảng $0,004. Hai con số này đúng cho Opus 5.5. Nhân với vài trăm lượt là thấy vì sao nên giữ ngữ cảnh của model đắt cho gọn và để subagent rẻ làm phần đọc dài dòng.
Fast mode: nhanh hơn, giá gấp đôi
Trong bốn model này, fast mode chỉ có trên Opus 5.5 và Fable 5.2. Theo tài liệu fast mode, nó tăng tốc độ sinh đầu ra tới 2,5 lần, không rút ngắn thời gian chờ token đầu tiên và giá gấp đôi giá thường: $8 và $40 cho Opus 5.5, $16 và $80 cho Fable 5.2. Fast mode dùng cache riêng, nên bật tắt giữa session là mất cache một lần.
Tính giá cho phần đuôi, đừng tính trung bình
Trên một lượt chạy 20 bài của WideSearch, một benchmark bên ngoài, do Anthropic thực hiện và công bố với ba lần thử mỗi bài, hai bài chiếm 43% tổng chi phí, còn nửa số bài rẻ nhất chỉ chiếm 10%. Khi so hai cấu hình, hãy nhìn riêng những việc khó nhất trong tập của bạn, vì chúng mang phần lớn hóa đơn.
Dùng gói Pro hay Max thì chọn thế nào?
Chọn theo hạn mức, không theo giá mỗi triệu token. Bảng giá ở mục trên là của API. Với gói thuê bao, câu hỏi thật là hạn mức tuần này còn đủ làm xong việc không.
Ba điều nên biết:
- Giữ mặc định Opus 5.5 ở
medium. Đó là thiết lập có sẵn của Claude Code từ bản v2.1.280. Gõclaude --versiontrong terminal để kiểm. Muốn chọn được Fable 5.2 thì cần từ v2.1.321. - Fable tốn hạn mức theo cách riêng. Nó có thể tính vào usage credits, là khoản tín dụng tách khỏi hạn mức gói. Điều này tùy gói bạn dùng, còn với gói Team thì tùy hạng tài khoản của bạn trong nhóm. Theo trang ưu đãi ra mắt Fable 5.2, gói Pro và tài khoản hạng tiêu chuẩn của gói Team được dùng Fable trong tối đa 50% hạn mức tuần, tới hết ngày 16/11/2026 theo giờ Thái Bình Dương. Sau đó, hoặc khi dùng hết phần 50%, Fable tính vào usage credits nếu bạn đã bật. Trong bảng chọn của
/model, dòng Fable ghi "Requires usage credits" khi nó tính vào khoản này. - Fast mode trên gói thuê bao chỉ tính vào usage credits, không tính vào hạn mức gói.
Bạn không cần biết lập trình để tự kiểm model nào hợp với mình. Chọn một việc có kết quả rõ ràng, chạy trên Opus 5.5, rồi mở một session mới và chạy lại đúng việc đó, cùng một yêu cầu, trên Sonnet 5.5. Nếu việc có sửa file, hãy làm trên hai bản sao của cùng một thư mục, để lần chạy sau không thừa hưởng kết quả của lần trước. Dùng hai lệnh:
/model
/usage
/model mở bảng chọn model. Lựa chọn được lưu làm mặc định, còn nếu chỉ muốn đổi cho session hiện tại thì bấm s trong bảng chọn. /usage cho xem chi phí của session và hạn mức gói đã dùng.
Ghi lại /usage trước và sau mỗi lần chạy, rồi so ba thứ: kết quả có đúng yêu cầu không, bạn phải sửa lại mấy lần và /usage nhích lên bao nhiêu. Số của session và thanh hạn mức gói là hai thứ khác nhau. Thanh hạn mức tính cả những việc khác bạn chạy trên cùng tài khoản, nên đừng chạy việc khác trong lúc đo. Sonnet làm xong mà tốn ít hạn mức hơn thì chuyển loại việc đó xuống Sonnet. Cái cần so là tổng hạn mức để ra được kết quả đạt yêu cầu, tính cả các lần sửa.
Trộn nhiều model trong một việc thế nào cho đáng?
Giao phần dễ kiểm cho model nhỏ, giữ quyết định và phần sửa code ở model chính. Ba cách dưới đây xếp theo mức đáng làm: đổi model đúng lúc, đặt subagent trên model nhỏ, rồi mới tới Advisor và nhóm subagent chạy song song.
Đổi model ở điểm nghỉ
Đổi model giữa session có hai cái giá. Hãy đổi khi một giai đoạn đã xong và test đã chạy.
Thứ nhất là cache. Theo tài liệu prompt cache của Claude Code, mỗi model có cache riêng, nên sau khi đổi bằng /model, yêu cầu kế tiếp không đọc được gì từ cache cũ và phải ghi lại toàn bộ cuộc trò chuyện. Bài hướng dẫn của Anthropic khuyên chạy /compact trước khi đổi để phần phải ghi lại ngắn đi.
Thứ hai là các khối suy luận, tức phần model tự ghi lại trong lúc nghĩ ở những lượt trước. Theo tài liệu về giữ khối suy luận, trên Claude API, lên bậc thì model mới đọc được, xuống bậc thì không. Fable 5.2 đọc được khối suy luận của Opus 5.5, Sonnet 5.5 và Haiku 5.5. Chiều ngược lại, Sonnet và Haiku không đọc được khối của Opus và không model nào trong ba model còn lại đọc được khối của Fable 5.2. Khối không đọc được bị bỏ qua lặng lẽ, không báo lỗi. Nó vẫn nằm trong lịch sử, quay lại model cũ thì đọc lại được. Vì vậy trước khi xuống bậc, hãy để model viết ra những gì đã quyết và việc còn lại.
Giao subagent cho model nhỏ
Subagent chỉ đọc và báo cáo là chỗ hợp nhất cho Haiku. Trong lịch sử của mình, 30,7% số lượt Haiku chạy trong subagent, so với 22,8% ở Opus, 21,2% ở Fable và 18,9% ở Sonnet. Đó là phân bố lượt dùng, không phải phép đo Haiku tiết kiệm được bao nhiêu.
Trong Claude Code, bạn đặt model cho từng subagent bằng trường model trong file khai báo. Ví dụ dưới đây theo bài hướng dẫn của Anthropic, đặt ở .claude/agents/log-reader.md:
---
name: log-reader
description: Đọc kết quả test và log, báo lại từng lỗi
tools: Read, Grep, Glob
model: haiku
---

Đọc log được giao. Với mỗi lỗi, báo tên file, tên test và dòng lỗi đầu tiên.
Không sửa code.
Gọi nó bằng một câu như "Dùng subagent log-reader đọc file test.log và báo lại lỗi". Nếu đây là file đầu tiên trong thư mục .claude/agents/, hãy khởi động lại Claude Code để nó được nạp.
Theo tài liệu subagent, trường model nhận haiku, sonnet, opus, fable, mã model đầy đủ hoặc inherit. Biến môi trường CLAUDE_CODE_SUBAGENT_MODEL đặt model cho subagent không khai báo gì, nhưng nó xếp sau model truyền lúc gọi và sau trường model trong file.
Ba chỗ dễ vấp:
- Bí danh
haikukhông phải lúc nào cũng là Haiku 5.5. Trên Anthropic API nó trỏ Haiku 5.5, cần Claude Code từ v2.1.293. Trên Amazon Bedrock, Google Cloud, Microsoft Foundry và Claude Platform trên AWS nó vẫn trỏ Haiku 4.5, model có giá $1 và $5 mỗi triệu token, gấp mười lần Haiku 5.5 với prompt ngắn. Muốn chắc thì ghi mã model đầy đủ hoặc đặtANTHROPIC_DEFAULT_HAIKU_MODEL. - Subagent Explore có sẵn chạy theo model của session, không tự dùng Haiku. Riêng khi session chạy Fable trên gói thuê bao, tài khoản Anthropic Console hoặc cổng kết nối qua
ANTHROPIC_BASE_URL, Explore chuyển sang model mà bí danhopustrỏ tới. Muốn phần khám phá code rẻ hơn, tạo một subagent tênExplorevớimodel: haiku. - Bí danh
opusplanlàm ngược lời khuyên ở mục này: Opus lập kế hoạch, Sonnet viết code. Mỗi lần ra vào chế độ lập kế hoạch là một lần đổi model và ghi cache mới. Hãy đo trước khi đặt nó làm mặc định.
Cách gán model theo vai trò ở một công cụ khác được mình mổ xẻ trong bài hướng dẫn Định tuyến model trong Oh-my-pi (OMP), dành cho Subscriber.
Advisor và nhóm subagent: đo trước khi bật
Hai cách này nghe hợp lý nhưng số đo của chính Anthropic khá dè dặt.
Advisor là tính năng thử nghiệm cho một model chính hỏi ý một model mạnh hơn ở bước khó. Trong tài liệu tối ưu chi phí, Anthropic đo Opus 5.5 ở high kèm Advisor là Fable 5.1 trên 370 việc lập trình: đạt 90,1% với $2,92 mỗi lần thử, so với 88,4% và $1,38 khi Opus chạy một mình. Tức thêm 1,7 điểm với giá gấp khoảng 2,1 lần và Anthropic gọi mức tăng này là sát ngưỡng nhiễu giữa các lần chạy.
Các cặp khác trong cùng bảng không cặp nào thắng rõ, có cặp còn thấp hơn chạy một mình. Mình so sánh các kiểu Advisor trong bài hướng dẫn riêng về Advisor, dành cho Subscriber.
Nhóm subagent chạy song song thì có một kết quả tốt hơn, trong một điều kiện hẹp. Anthropic cho tìm 130 lỗi cài sẵn trong khoảng 22 triệu token code Python, tối đa 25 subagent cùng lúc. Số dưới đây là trung bình 10 lần chạy trên Claude Managed Agents, subagent chạy ở effort mặc định của nó, tức high với Sonnet 5.5 và medium với Haiku 5.5. F1 là điểm gộp giữa tìm đủ lỗi và tìm đúng lỗi, cao nhất là 1:
| Cấu hình | F1 trung bình | Chi phí mỗi lần chạy |
|---|---|---|
Opus 5.5 ở medium chạy một mình | 0,827 | $200 |
Opus 5.5 ở high dẫn các subagent Sonnet 5.5 | 0,831 | $139 |
Opus 5.5 ở high dẫn các subagent Haiku 5.5 | 0,677 | $47 |
Opus dẫn Sonnet rẻ hơn khoảng 30% mà điểm gần như bằng. Đổi sang Haiku thì rẻ hơn nữa nhưng điểm tụt rõ. Anthropic cũng ghi rằng cách chia này chỉ lợi khi vài việc khó chiếm phần lớn chi phí, hoặc khi việc lớn hơn một context window. Với một chuỗi bước phụ thuộc nhau, như phần lõi của migration trong ví dụ, một model chạy một mình ở effort thấp hơn đã làm tốt hơn trong các phép đo trên model đời trước.
Đổi model trên API cần soát gì trước?
Soát năm chỗ dưới đây, vì đổi mã model mà giữ nguyên cấu hình cũ có thể trả lỗi 400. Nếu bạn chỉ dùng Claude Code và không tự gọi API thì chỉ cần đọc ý cuối.
- Suy luận luôn bật trên Opus 5.5 và Fable 5.2. Truyền
thinkingở dạngdisabled, hoặcenabledkèmbudget_tokens, đều trả lỗi 400. Sonnet 5.5 cũng trả lỗi 400 khi tắt suy luận. tool_choicevới giá trịanyhoặctooltrả lỗi 400 trên Sonnet 5.5, Opus 5.5 và Fable 5.2. Dùngautovà nói rõ trong prompt khi nào cần gọi công cụ.- Với Fable 5.2, sửa bất kỳ nội dung nào đứng trước một khối suy luận đã lưu sẽ trả lỗi 400. Opus 5.5, Sonnet 5.5 và Haiku 5.5 cũng vậy với tài khoản tạo từ ngày 31/08/2026. Giữ lịch sử hội thoại theo kiểu chỉ thêm vào cuối.
- Từ Haiku 4.5 lên Haiku 5.5: đổi
thinkingtừ dạngenabledkèmbudget_tokenssang{"type": "adaptive"}, hoặc bỏ hẳn trường này, rồi đặt mức effort ởoutput_config.effort. Kết thúcmessagesbằng lượt của trợ lý (assistant) để điền sẵn câu trả lời sẽ trả lỗi 400. Tài liệu của Haiku 5.5 ghitemperature,top_pvàtop_kcó thể trả lỗi. Hướng dẫn chuyển sang Haiku 5.5 khuyên bỏ chúng. Cùng một đoạn văn bản cũng ra nhiều hơn khoảng 30% token so với Haiku 4.5. - Fallback an toàn trong Claude Code khác nhau theo model. Yêu cầu bị bộ phân loại chặn trên Fable hoặc Opus 5.5 được chạy lại trên Opus 4.8 nếu thuộc nhóm an ninh mạng, trên Opus 5 nếu thuộc nhóm sinh học. Sonnet 5.5 chuyển sang Sonnet 5 với nhóm an ninh mạng và từ chối nhóm sinh học. Sau khi fallback, session ở lại model fallback, nên hãy kiểm lại bằng
/model.
Mã model cố định của bốn model là claude-fable-5-2, claude-opus-5-5, claude-sonnet-5-5 và claude-haiku-5-5.
Vậy hôm nay bạn quyết gì?
Bốn quyết định, theo thứ tự:
- Mặc định là Opus 5.5 ở effort
medium. - Xuống Sonnet 5.5 khi việc rõ phạm vi và kiểm được. Xuống Haiku 5.5 cho việc đơn giản số lượng lớn và subagent chỉ đọc.
- Thử Fable 5.2 khi Opus ở
highvẫn hụt, hoặc việc lớn và nhiều quyết định ràng buộc nhau. - Chỉnh effort trước khi đổi model và cho model tự kiểm trước khi chỉnh effort.
Các số đo benchmark trong bài là của Anthropic, đo trong điều kiện của họ. Muốn có câu trả lời cho việc của bạn, hãy tự đo theo bốn bước mà bài hướng dẫn của Anthropic gợi ý:
- Lấy vài việc thật, mỗi việc có một phép kiểm kết quả: test chạy qua, yêu cầu hỗ trợ đóng được, số dòng dữ liệu khớp.
- Chạy mỗi model ở hai hoặc ba mức effort, mỗi lần một session riêng, bắt đầu từ cùng một trạng thái repo.
- So kết quả với chi phí hoặc hạn mức đã dùng. Chỉ giữ cấu hình trộn nhiều model nếu nó cho kết quả ngang hoặc hơn với chi phí thấp hơn mọi cấu hình một model.
- Chạy song song cấu hình mới trên một phần việc thật, trong bản sao riêng, trước khi chuyển hẳn.
Dùng bài này trong agent của bạn
Lấy API keyChép đoạn dưới, dán vào Claude Code, Codex hay agent bạn đang dùng. Agent đọc bài rồi đối chiếu với repo đang mở.
Đọc bài "Nên dùng model Claude nào: Fable 5.2, Opus 5.5, Sonnet 5.5 hay Haiku 5.5?" trên modernEngineer rồi áp dụng vào repo này.
1. Gọi tool content_get của MCP server modernengineer với locale "vi", slug "chon-model-claude-fable-opus-sonnet-haiku". Nếu chưa nối MCP hoặc bị từ chối quyền, đọc thẳng trang https://modernengineer.dev/vi/library/chon-model-claude-fable-opus-sonnet-haiku.
2. Tóm tắt các bước chính của bài, chỉ ra bước nào áp dụng được cho repo này.
3. Đề xuất thay đổi cụ thể và hỏi tôi trước khi sửa file.
Nối MCP cho Claude Code (một lần)
claude mcp add --transport http modernengineer \
  https://api.modernengineer.dev/mcp \
--header "Authorization: Bearer <API key>"Bài mở cho mọi người: chưa nối MCP thì agent vẫn đọc được thẳng từ link bài.
- Phiên bản
- v1.0.0
- Cập nhật
- 11/11/2026
- Giấy phép
- Bảo lưu mọi quyền
- Slug
- chon-model-claude-fable-opus-sonnet-haiku